把 ComfyUI 工作流作为公共服务,同时不暴露 ComfyUI
作者: Anastasiia Butova, ComfyUI 与扩散模型工程师,贝尔格莱德 · 发布于 2026-09-23
译自英文版: English
/mashinki/ 上的汽车工作室让任何人把一辆车放进展厅,按下渲染,然后拿回一帧来自真实流水线的画面:FLUX.2 Klein 9B 加上我们的几何修复 LoRA,运行在 mashinki 的 GPU 主机上,耗时 30 到 60 秒。渲染它的 ComfyUI 根本不发布到互联网上。两者之间是一个小型 Python 服务。本文讲的是它接受什么、拒绝什么,以及我最初把隧道放在哪里却行不通。
我所做的每一条生产 ComfyUI 流水线都是这样运行的:图由代码提交,而不是在编辑器里点出来的(这类工作的更多内容见 /comfyui/)。通常调用者是一个后端。而这里的调用者是任何拿着浏览器的人,这让每一个设计问题都更加尖锐。
为什么 /prompt 永远不面向互联网
ComfyUI 的 HTTP API 是为机器的所有者设计的。POST /prompt 接受一整张 API 格式的图并运行它。图就是一个程序:一个加载节点接受文件名,一个保存节点写入文件,而服务器上安装的每个自定义节点,都是调用者可以带着自选参数调用的又一个函数。因此,任何能访问 /prompt 的人,都可以在机器上加载任何模型,读取 ComfyUI 进程能读的任何东西,并写入它能写的任何地方。那个请求中没有一个字段是你可以校验的,因为请求本身就是代码。
对我来说,这并非纸上谈兵。2026 年 2 月,我参与维护的一台 GPU 服务器上的 ComfyUI 容器在挖门罗币。它的 API 端口未经认证就暴露在互联网上,有人向它发送了一个包含第三方包中 eval 节点的工作流,而他们的 Python 改写了 ComfyUI 自己的 execution.py。我写了清除运行手册,完整经过见 关于生产环境中自定义节点的文章。4 月,Censys 描述了一场针对暴露在互联网上的 ComfyUI 的攻击活动,至今它仍能找到一千多个实例,而同一个节点也在它的列表上。
因此 mashinki 主机上的 ComfyUI 没有发布在任何地方。服务在主机本地的 127.0.0.1 上访问它,公众只与服务通信,而服务没有任何方式表达一张图。
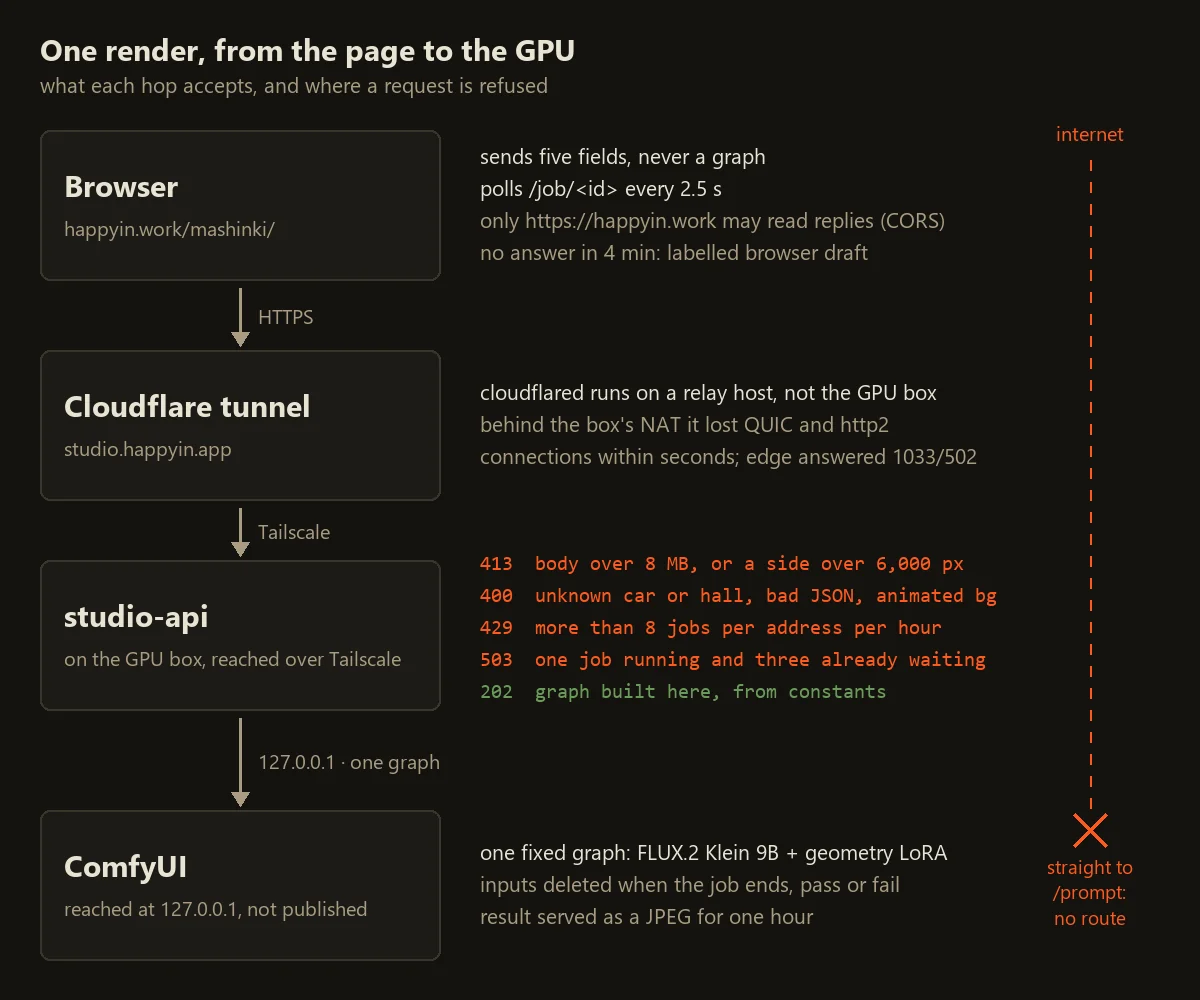
六个值,图在我们这边构建
渲染按钮发送 POST /compose,其中包含五个字段。服务认识六个,因为大厅和你自己的背景是二选一的。每一个在触碰任何东西之前都有边界:
| 字段 | 接受的内容 |
|---|---|
car |
四个 id 之一,用作字典键 |
scene |
七个大厅 id 之一,用作字典键;除非发送了 bg,否则必填 |
x |
数字,限制(钳制)到 12–88(画面宽度的百分比) |
y |
数字,截断到 40–96(地面线,画面高度的百分比) |
scale |
数字,截断到 34–94(车宽,画面的百分比) |
bg |
可选的 base64 静态图像,见下文 |
未知的车或大厅、无法解析的 JSON,或者不是数字的坐标,都会得到 400。服务不认识的字段永远不会被读取。检查就像它看起来那样朴素;以下是生产代码:
car = str(spec.get("car", ""))
scene = str(spec.get("scene", ""))
bg = spec.get("bg")
if bg is not None and not isinstance(bg, str):
    return self._json(400, {"error": "bg must be a base64 string"})
if car not in CARS:
    return self._json(400, {"error": "unknown car"})
# A hall is required only when the caller did not bring their own plate.
if not bg and scene not in SCENES:
    return self._json(400, {"error": "unknown scene"})
try:
    x = float(spec.get("x", 50)); y = float(spec.get("y", 82)); sc = float(spec.get("scale", 62))
except (TypeError, ValueError):
    return self._json(400, {"error": "x, y and scale must be numbers"})
x = max(12.0, min(88.0, x)); y = max(40.0, min(96.0, y)); sc = max(34.0, min(94.0, sc))
图在服务内部是一个 Python 字典,其中除一个值之外,其余全部来自生产环境,而不是我手写的。模型文件、第 2,000 步的 LoRA、6 步、采用 beta 调度器的 euler 采样器,以及逐字照搬的生产提示词,于 8 月 28 日从正在运行的调度器容器中复制而来,代码中注明了每个值来自哪个文件。调用者对这张图的影响很小,而且是间接的:它所加载的合成图是服务以自己生成的名字写下的文件;提示词中的车身类型和尺寸,则来自一张包含四个条目的表,即我们的车辆识别服务对那四帧返回的值。种子也是我们自己的。
有一处与生产环境的差异是刻意为之的。生产环境以 0.7 的强度运行适配器。在本站上,我以 1.0 运行,因为演示画面允许比经销商批量渲染更进一步,而页面在渲染时会把这个数字打印出来。
尽早拒绝,尽晚解码
大部分思考都花在检查的顺序上。它们按照从最便宜到最昂贵的顺序运行:
Content-Length超过 8 MB:返回 413,不解析请求体。- 某个地址已经用完它一小时的额度,还在发送超过 2 KB 的数据:返回 429,同样不解析请求体。这项检查不消耗任何东西。
- 解析 JSON 并校验字段。
- 额度:每个地址每小时八个作业,否则返回 429。地址取自 Cloudflare 在
CF-Connecting-IP中传递的值。任务在此计数,因此下一步返回的 503 仍然会消耗一个额度。 - 队列:一个任务运行,最多三个等待,否则返回 503。
- 只有到了这一步,如果发送了背景,才会解码它。
图像是服务为陌生人所做的最昂贵的事情,而我们不欠那些本来就会被拒绝的人任何解码工作。
413 教会了我一件我没有预料到的事。如果服务在调用者还没有上传完毕时就作出回应,上传会被重置,而前面的隧道会返回它自己的 502。实测:一个 20 MB 的请求体得到的是 Cloudflare 的 502,而不是我们的 413,调用者看到的是一个损坏的网关,而不是原因。现在服务会读取请求体,并以 64 KB 为单位丢弃,最多读到 64 MB,然后返回它自己的 413;对于声明更大的请求,它在 64 MB 处停止、作出回应并关闭连接。20 秒的套接字超时会断开在上传中途失去声息的调用者。
调用者唯一可以发送的东西
访问者可以带来一张他们自己的大厅照片。它以 base64 的形式在同一个 JSON 中到达,而且从不会按原样传递下去。下面是从 save_plate 中裁剪出来的,并加上了我的三条简短注释:
im = Image.open(io.BytesIO(raw))              # reads the header, not the pixels
if im.format not in PLATE_FORMATS:            # JPEG, PNG, WEBP
    raise PlateRefused(400, "background must be a jpeg, png or webp still")
if getattr(im, "n_frames", 1) > 1:
    raise PlateRefused(400, "background must be a still image, not an animation")
w, h = im.size
if w < 64 or h < 64:
    raise PlateRefused(400, "background is too small to place a car in")
if w > MAX_SIDE or h > MAX_SIDE:              # 6,000 px
    raise PlateRefused(413, "background is larger than %d px on a side" % MAX_SIDE)
im = im.convert("RGB")                        # decodes here, inside the bound checked above
im.save(path, "JPEG", quality=92)             # our encoder, our bytes, from this point on
尺寸是在解压任何像素之前从文件头中读取的,因此一个声明为 8000×8000、只有 79 KB 的文件,在被解压之前就会被拒绝。只接受三种格式,因为这就是浏览器文件选择器对一张照片实际能给出的格式,而 PIL 携带的其他每一种解码器,都是我们白白暴露、对谁都没有好处的攻击面。动画会被拒绝,所以任何东西的第二帧都永远不会被解码。然后,图片被重新编码为我们自己的 JPEG。无论文件容器里藏了什么,比如图像数据之后的有效载荷,或者恶意的元数据块,都无法保留下来,因为它们都不是像素。
背景以作业 id 命名,在作业结束后(无论成功与否)被删除。在进程重启时仍在排队的作业永远到不了它的清理步骤,因此一个定期清扫会删除任何超过一小时的背景文件。
还有一个细节改变了提示词。对于我们的七个大厅,只要我们测量过,提示词就会带上背景提示:两个深色大厅会得到"保留深色帷幕和深色天花板的曝光"。而对于陌生人的照片,提示词是空的,而不是猜测。我们从未测量过那个房间,错误的提示会推动模型已经能看到的一个房间的曝光。
保留什么,保留多久
作业 id 是从一个随机 UUID 中截取的 16 个十六进制字符。/job/<id> 和 /img/<id>.jpg 符合严格的模式,而 /img/ 只提供本进程中已完成作业的内容。它提供的 JPEG 保留一小时;每五分钟运行一次的清扫会删除它并忘记该作业。送入 ComfyUI 输入文件夹的 2048 像素合成图,在 finally 块中被删除。在修复之前,失败的渲染会把合成图永久留在那里。
Access-Control-Allow-Origin 固定为 https://happyin.work。值得准确地说明它买到了什么。CORS 只能阻止另一个网站上的脚本在浏览器中读取我们的响应;它阻止不了 curl。真正限制滥用的,是狭窄的输入、每小时的额度和队列。CORS 只是防止别人的页面把工作室当作它自己的后端来驱动。
页面可以显示的状态
POST /compose 立即以 202 作答,并返回一个作业 id;GPU 的工作稍后才进行。页面每 2.5 秒轮询一次 GET /job/<id>,画面下方的标签就是主机自己的状态:waiting、compositing、queued-on-gpu、rendering,然后是 done 或 error。我希望这些文字来自主机,因为计时器和 GPU 一旦 GPU 忙碌起来就会不一致。进度条只跟随经过的时间,并沿着一条永远不会到达 100% 的曲线走;只有返回的画面才能让它结束。
在服务内部,它每半秒轮询一次 ComfyUI 的 /history。它过去是每四秒一次。生产调度器以 0.2 秒轮询,而四秒的间隔意味着 GPU 已经完成后,观看者还要多等最多四秒,在一次约 45 秒的渲染中,这占了他们能看到的大部分额外开销。8 月 28 日测得的两次渲染耗时分别为 29.5 秒和 57.2 秒。
如果主机拒绝或失去响应,页面会改在浏览器中合成汽车,并在画面上说明。返回的渲染图标注为 rendered on the gpu,本地的标注为 browser composite · draft,说明文字则根据状态码给出原因:本小时的八帧已经用完,GPU 队列已满,文件太大,主机拒绝了这一帧,或者 GPU 没有响应。轮询四分钟之后,页面就停止等待。访问者绝不应该把浏览器里的粘贴误认为模型的输出。
隧道,以及它无法运行的地方
公开的名字是 studio.happyin.app,通过 Cloudflare 隧道提供服务。cloudflared 的显而易见的位置是 GPU 主机本身:隧道是向外拨号的,所以 NAT 不应该有影响。它确实有。在 mashinki 主机的 NAT 之后,cloudflared 注册了连接,却在几秒之内就丢失了它们,无论是通过 QUIC(failed to dial to edge with quic: timeout: no recent network activity)还是 http2,边缘节点一直返回 1033 和 502。
我没有去对抗那个 NAT。隧道现在运行在我们的另一台拥有稳定连接的机器上,作为一个 systemd 单元,包裹官方的 cloudflared 镜像,使用主机网络,并通过 Tailscale 连接到主机。服务不知道、也不关心隧道运行在哪里。
不过,NAT 并不是代价最大的错误。在这一切能工作之前,我曾经写下,阻碍因素是 happyin.work 区域缺少一个 Cloudflare 令牌的权限范围。事实并非如此。我已经拥有的一个令牌,就能在另一个账户上创建隧道和 DNS 记录;而且端点根本不需要位于 happyin.work 之下:happyin.app 上的一个主机名就能完成任务。那个阻碍是我对自己访问权限的一个假设,我本应在写下"被阻塞"之前,先检查我的凭据能做什么。
限制
- 额度和作业表都保存在内存中。进程重启会忘记谁用掉了多少额度,并丢弃排队中的作业;清扫只保证它们上传的背景不会超过一小时。
- 为这篇文章重读代码时,我发现有一个文件没有被任何东西删除:ComfyUI 的保存节点写入其输出文件夹中的 PNG,包括对观看者自己照片的渲染。服务现在会在把画面复制出来之后立即删除它。第一次尝试悄无声息地失败了,因为 ComfyUI 以 root 身份运行,并创建了一个属于 root 的文件夹;删除时抛出了权限错误,而代码把它吞掉了。是在一次渲染前后各统计文件夹内的文件数(先 7 个,然后 8 个)才发现的。现在该文件夹归服务的用户所有,删除失败会被打印出来,而不是被忽略。
- 汽车渲染一次只运行一个。一个作业运行、三个等待时,第五个作业会得到 503,而观看者得到的是草稿。
- 套接字超时只能捕捉静默,而无法捕捉缓慢的涓流,因此线程有可能以这种方式被长期占用。现在请求体有它自己的期限:整个请求 90 秒,而不是每次读取 20 秒。
- 没有账户。任何人都可以从一个地址每小时用掉八帧,对于一个演示来说,这是恰当的代价。
我会再做一次的做法
根据实时流水线中复制出来的常量构建图,并附上注释说明每个值来自哪个文件;当生产环境改变时,差异会显示出来。按成本从低到高检查,最后才解码。把陌生人上传的任何东西都重新编码:这只需要几行,却消除了一整类关于文件中还藏着什么的问题。给每个输出标注它实际来自哪里。
而且要让 ComfyUI 远离互联网。它的 API 从来不是为陌生人设计的,而挡在它前面的那个狭窄服务只是一点很小的代价。如果你需要把自己的工作流变成 API 或公共工具,那正是 /comfyui/ 上所描述的工作。