为什么扩散模型在 4000 万像素照片上画出接缝,以及如何让分块拥有记忆
作者: Anastasiia Butova, ComfyUI 与扩散模型工程师,贝尔格莱德 · 发布于 2026-04-26 · 更新于 2026-09-23
译自英文版: English
一个专业修图文件有 40 到 150 百万像素,而扩散模型一次只能处理一到四百万像素,因此每条流水线都要把照片切成分块。这带来两个问题:分块边界处出现可见的台阶,以及模型对自己所处的画面一无所知。本文讲的是:为什么混合无法消除台阶;视频扩散中的哪些记忆机制可以从帧搬到分块上;为什么每个分块都应该获得整张图像以及它自己的坐标;以及我的首批运行显示了什么,包括失败。我做了二十多年修图师,现在在使这些模型在这类文件上表现正常的工作上,已经进入第四年;这项工作属于 Happyin.ai 背后的高分辨率 img2img 研究。2026 年 9 月修订:更正和后来的结果都标注了这个日期。
为什么每个人都要分块
修图并不局限于 2048 像素的边长。Phase One IQ4 能拍出 14200×10600,Hasselblad H6D-100c 为 11600×8700,Canon R5 为 8192×5464,而这些照片仍然需要处理皮肤、头发、色彩、光线和背景。当前的模型原生支持 1024 到 2048:SDXL 和 SANA 为 1024(SANA 经过了进一步训练,可到 4K),FLUX 和 Klein 在 2048 下表现尚可。低于 1024,质量下降,分块数量随之增加。
以 1024 的分块加上小重叠计算,一张 60 MP 的文件大约需要 75–80 个分块,100 MP 约 130 个,150 MP 约 190 个。重叠是用来掩盖接缝的,但它会成倍增加数量:同一张 150 MP 文件,在 25% 重叠时约 270 个分块,50% 重叠时约 540 个。因此每张图 150 个以上的分块是正常的工作情形,任何代价随分块数平方增长的机制,都在开始之前就已经出局。它放不进 80 GB 的显存,即使是 192 GB 也放不下。
为什么混合无法消除接缝
重叠加混合是通常的解决办法,但混合在不同频率上的表现不同。在平滑的内容上(天空渐变、肤色、金属反光中的柔和衰减),交叉淡化能很好地掩盖颜色台阶。而在头发、石头、颗粒或细微划痕上,它会以两种方式之一失败:边界上仍然留有硬台阶,或者纹理被抹平,因为在重叠区域内,你是在平均两块由模型独立绘制的纹理。
抹平有一个简单的数字依据。两个不相关的、对比度相同的纹理,按 50/50 平均之后,会保留 √0.5 的对比度,约为 71%。在下面的示意图中,我在重叠带中部测得了 0.70。
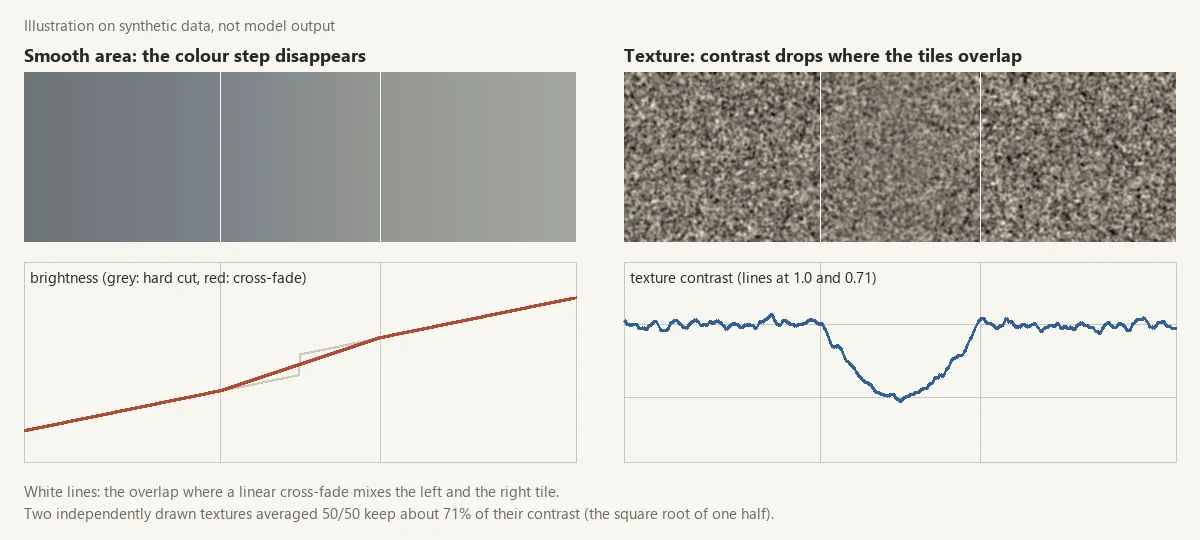
一个旋钮无法同时解决两个问题:混合越强,颜色接缝越柔和,但沿每条分块边界的纹理就越平。而颜色台阶本身来自各个分块各自漂移。没有任何东西告诉分块 (3, 5) 它的邻居 (3, 4) 选了什么颜色。
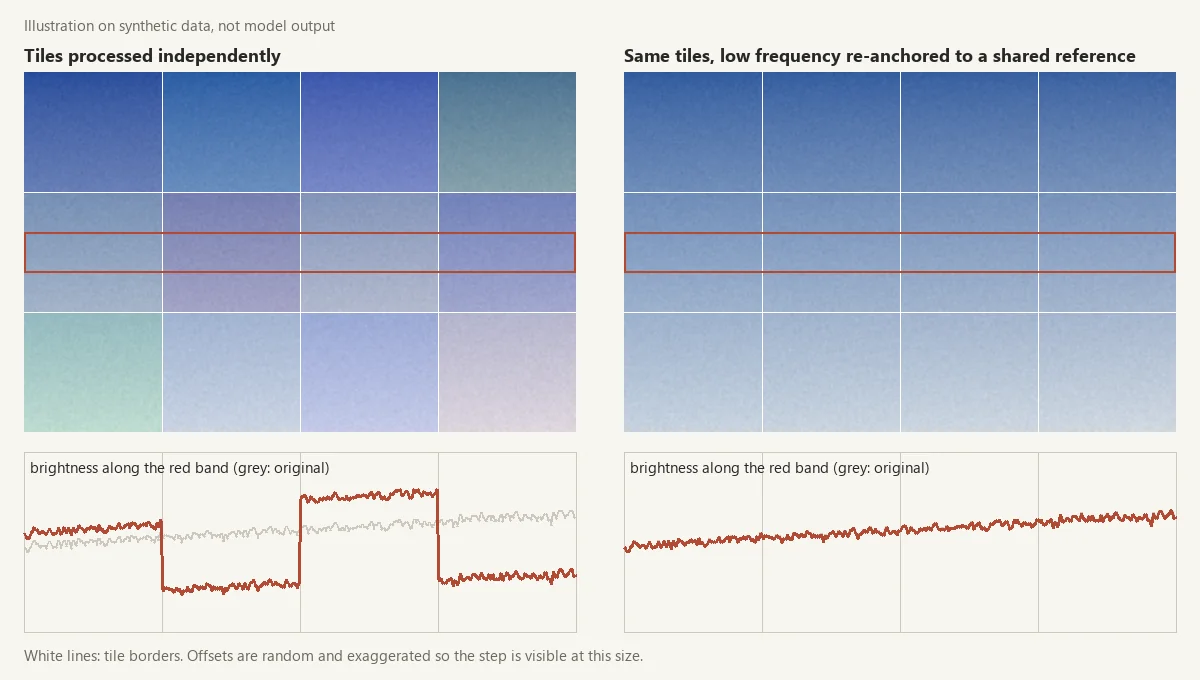
在这个玩具示例中,分块边界处最大的台阶从 255 级中的 18.5 降到了 0.5。偏移量被夸大了,但原理正是本文全部的方向:给每个分块一个与其邻居共享的参照,并且针对这个参照修正低频,而不是让它们彼此对齐。ResMaster 在生成中做了这一思路的一个版本:在每个去噪步骤中,把每个小块的低频分量与一个低分辨率参照对齐。
分块的记忆机制需要做什么
- 成本不随分块数平方增长。 完整的三维注意力出局。
- 无需重新训练就能使用。 即使只能部分地在推理时使用,也是很大的优势。
- 连续、像素级精确的输出。 我们做的是修饰纹理,而不是生成一种审美。像 Cosmos 这样的离散 token 模型,其 64K 的 FSQ 词表会把精细细节量化掉。
- 一个我能拆出来的原语。 Wan 2.1(14B)和 HunyuanVideo(13B)承载长视频、运动控制、音画同步和多镜头合成;其中一半解决的是照片不存在的问题,而我会为了这些在显存上付出代价。SANA-Video、AnimateDiff、SVD 和 FramePack 各自分离出了它们的记忆原语。并且尽可能采用 Apache 2.0 许可,使结果可以进入产品而无需谈判。
我选择的主要方向,是机制如何遗忘已经完成的分块,使得 200 个分块不会把它们全部的 K/V 张量都留在显存中。滑动窗口只保留最近的几个,对远处的内容视而不见。几何压缩则是邻居保持全分辨率,远处的分块被压缩,使总量收敛。累积状态则根本不保留分块,只保留两个小的运行和。
想法一:视频模型记得帧,照片模型不记得
所谓"照片模型",我指的是普通的图像到图像扩散模型:SDXL、FLUX、Klein、SANA。当视频模型生成第 18 帧时,它同时能看到第 17、16 帧,某些早期的关键帧,有时还有第一帧。这种记忆存在于架构之中(时间轴上的注意力、累积状态、各块之间的 KV 缓存),正因为如此,背景不会抖动,颜色在帧与帧之间也不会漂移。
处理分块 (3, 5) 的照片模型,得到的是它的像素和一个文本提示词。它没有左边的邻居,也没有上面的邻居,不知道这是同一张图片的一部分。把记忆从时间轴搬到空间网格上,就能同时解决接缝问题(分块记住邻居的颜色)和部分语义问题(头发分块知道脖子从下方开始,而不是长出毛皮)。视频文献中有八类架构上的记忆方式,但并非全部都能在平面上存活:
| 类型 | 机制 | 例子 | 用于分块 |
|---|---|---|---|
| A · 完整三维注意力 | 每个 token 看到每个 token | Wan | 放弃:平方复杂度,64 个以上分块无法启动 |
| B · 块线性注意力 | 运行和 S = Σ φ(K)ᵀV,Z = Σ φ(K)ᵀ | SANA-Video | 主要:恒定状态 |
| C · 滑动窗口 | 关注最近的 W 帧 | CausVid | 备选:局部很好,但对远处的分块视而不见 |
| D · 空间与时间分解 | 每个空间层之后加时间层 | SVD、AnimateDiff | 直接映射:"跨所有帧"变成"跨所有分块" |
| E · 锚点帧 | 每一帧都关注一个锚点 | Rolling Forcing、StreamingT2V | 附加:一个锚点分块来对齐颜色 |
| F · 几何压缩 | 近的帧全分辨率,远的压缩 | FramePack | 主要:邻居全分辨率,对角线 2 倍压缩,远处 4 倍 |
| G · 缓存共享 | 特征只计算一次,在各步之间复用 | Ca2-VDM | 附加:邻居特征只计算一次 |
| H · 离散 token | FSQ 词表,下一 token 预测 | Cosmos | 放弃:与连续的像素编辑不兼容 |
其中三类最为重要。
B,来自 SANA-Video 的块线性注意力。 每个块(那里是一帧,这里是一个分块)把它的键和值加到两个累加器中,下一个块从累加器中读取,而不是从之前的每个 token 中读取。状态不随块数增长,因此一百个分块的成本与十个分块相当。SANA 已经在每一层都使用线性注意力,因此这一原语是现成的。
2026 年 9 月更新。 四月版文本估计 SANA 1.6B 的这个状态约为 380 MB,使用的宽度是 2,304、层数是 28。这两个数字对该模型都是错的:2,304 是文本编码器嵌入的宽度(
caption_channels),而 28 层属于 0.6B 模型。SANA 1.6B 有 20 层,每层 70 个头,每个头 32 维(config),其线性注意力按头保存 S 和 Z,使用 fp32(diffusers 中的SanaLinearAttnProcessor2_0)。也就是每个头 33×32 个数,20 层合计约 6 MB。即便是粗略的计算,每层一个 2,240×2,240 的 fp16 矩阵,也约为 200 MB。结论反而更强:这个状态与分块数量无关,而且很小。
D,来自 SVD 的空间与时间分解。 SVD 在 SD 2.1 UNet 的每个空间层之后插入了时间卷积层和时间注意力层:在 1,521M 参数中新增了 656M 参数,因此视频部分占模型的 43%。(俄文原文写的是 SDXL;SVD 论文写的是 SD 2.1。2026 年 9 月更正。)从机制上看,它只是一次 reshape:经过一个空间块之后,(B·T, C, H, W) 变为 (B·H·W, T, C),经过时间注意力,再变回来。把分块数放在 T 的位置上,"这个像素在每一帧中是什么样子"就变成了"这个位置在每个分块中是什么样子"。这是最字面的移植,我原以为它最脆弱。AnimateDiff 的运动模块是同一思路,已经训练好,推理时可用,但上限是 32 帧,也就是 32 个分块。
F,来自 FramePack 的几何压缩(作者是 ControlNet 的作者 Lvmin Zhang)。近的帧以全密度进入上下文,远的帧压缩得更厉害,使总量收敛到一个固定上限。对于分块:(3, 5) 以全密度看到 (2, 5)、(3, 4)、(3, 6) 和 (4, 5),对角线以 2 倍压缩,远处的分块以 4 倍压缩。无论照片尺寸如何,上下文都保持不变,因此 16×16 的网格也能工作,而不会出现平方级的爆炸。
最接近的已有工作沿着相邻的方向发展。PatchVSR 把视频模型改造成逐块超分辨率,但它的时间注意力局限在一个块之内,跨的是该块的各帧。Sliding Tile Attention 在视频 DiT 中把注意力加速到 FlashAttention-2 的 2.8–17 倍;滑动分块的想法来自那里,但它是一个速度成果。(四月版文本把这个范围说成端到端的,而论文中它指的是注意力部分。2026 年 9 月更正。)FrescoDiffusion(2026 年 3 月)是最接近的近亲:它为 4K 图像到视频做分块去噪,每个时间步都把每个分块与一个低分辨率参照融合。它生成的是视频,而不是编辑照片。我没有找到任何系统性的实验,把视频的时间注意力作为静态图像的跨分块注意力,并跨不同的骨干网络来检验。
一个由邻居而非分块构成的数据集
几乎没有人写数据集,但它是任务的一半。要学会记住邻居,模型必须看到邻居的序列。我使用的是条带(strip):穿过照片的一条直线行或列,切成分块。
来源是我手头的一套珠宝图片,约 52,500 张照片。珠宝集中了朴素分块会失败的所有情形:细薄的边缘、折射、带有不均匀阴影的反光金属,以及带有细纹理的宝石。每张照片在三种尺度(512、768、1024)、三种重叠(0%、25%、50%)、四个方向上切分。只存储从左到右和从上到下的条带;反向的条带在加载器中通过 np.flip 生成。这种反转很重要,因为块线性注意力是因果的:一个分块只看到它之前各分块的运行摘要,如果只从左到右训练,它就从未见过任何其他走向。
纸面上,每张照片约 70 个条带,整套数据约 300 万到 400 万个样本。这条流水线设计为在存储 400,000 个条带时停止,第一轮分块缩放到 256×256,并保留原图,以便之后重新切分。2026 年 9 月检查:根据其清单,迄今唯一的一次运行从 100 张照片中切出了 7,368 个条带,每张 74 个,与估计接近。
构建它时得到了本周最有用的一个观察:条带会穿过物体的边界。 在一张 5184×3456 的照片上,尺度 512 的第 4 行依次是皮肤、皮肤、皮肤、指尖、手镯珠子。以每秒 24 到 60 帧计,连续的视频帧相隔 17 到 42 毫秒,运动很小,光流平滑;而相邻的分块可能一步从皮肤跳到金属。半个分块的步长使条带表现得像缓慢的摇镜头,而最终的数据集混合了三种重叠,从硬跳变到平滑的摇镜头都有。
我在四月做了什么
在最初的文章中,只用了 SANA。它是在 512 上训练的,然后是 1024、2K 和 4K,因此 1024 的分块是原生的,而且线性注意力已经在骨干网络中。我在 1024 分块的测试条带上做了一次小规模训练,回答两个问题:损失是否收敛,以及这一机制是否能从时间轴迁移到空间平面上。损失收敛了,模型学会了协调相邻分块,就像它过去协调相邻帧一样。我当时没有发布测试运行的数字,现在也不发布。
2026 年 9 月更新。 重新阅读项目仓库时,我没有找到那次 SANA 训练的日志;仓库保存的损失曲线属于另外两个移植。所以请把上面关于 SANA 的那句话看作我四月的报告,而不是证据。那一周的运行笔记中确实记录了:在推理时,打开或关闭 SANA 的累积状态,会使输出平均改变 19.5 个 255 级(而合理性检查的阈值是 0.5 以下)。也就是说,这一机制不是悄无声息的空操作,这远没有达到"更好"的程度。另外两个移植是在一组约 7,000 张、尺寸为 1024 像素及以上的照片所构成的分块序列上微调的。SDXL 加上跨分块的 SVD 式注意力:损失的 100 步滑动平均下降了约 40%,预测具有可辨识的结构,但出现了与分块网格对齐的对角线摩尔纹,我把它归因于我的实现在分块间对键和值做了均值池化。SD 1.5 上的 AnimateDiff 运动模块:权重确实变了(更新的 Frobenius 范数为 15.28),然而微调前后的输出看起来几乎相同。笔记在损失下降了多少这一点上互相矛盾,所以我不写那个数字。我把这些相同的输出解读为运动模块用于分块的一个负面结果,我的工作解释是上文的内容跳变:这些模块带有一种平滑运动的先验,而照片并不满足这一先验。两者都是训练不足的快照,所以这些数字是下界,而不是结论。
想法二:让每个分块看到整张图和它的位置
如果你把一张 6000×4000 的照片切成分块,那么你就拥有了整张图像,而不去利用它是很奇怪的。在潜空间中把它降采样,然后把它与每个分块一起作为额外通道送入第一个卷积层。再加上分块的位置,即两个额外通道 (x, y) ∈ [−1, 1],这样分块 (3, 5) 就知道自己是 (3, 5),而不是虚空中的某个 512 像素区域。PatchVSR 在视频超分辨率中同时做了这两件事:一个全局分支看到缩小后的整段视频,而分块的位置被注入模型。
位置值多少:PaDIS
PaDIS(Hu 等,NeurIPS 2024)只在分块上训练扩散先验,并且为每个分块拼接了两个位置数组:完整图像中每个像素的 x 坐标和 y 坐标,缩放到 [−1, 1],且不对它们添加噪声。他们附录中的消融(表 6,CT 重建)很直白:有位置时 PSNR 为 33.57 dB,没有位置时为 23.25 dB,而即使用基线重建初始化,没有位置仍然是 24.51 dB。作者写道,网络"完全没能学会基于分块的先验"。十分贝是能用与不能用之间的差距。
借用这个数字之前有两点要注意。它来自 CT,而不是照片,而且是一个从头训练的、在分块上工作的像素空间模型。没有人测量过,坐标对一个预训练的潜空间模型、在 40 MP 修图上能带来什么;那个实验是我列表上的第一项,尚未完成。
它之所以重要,很容易理解。没有位置,一个函数必须在没有任何办法把知识与位置关联的情况下,修复每一个分块("人脸通常在这里,天空渐变在那里"),于是它只能取平均,而平均之后的结果看起来就像噪声。每个像素两个数字的成本几乎为零,而几乎没有分块流水线会提供它们,大概是因为预训练模型的输入宽度是固定的,每增加一个通道都意味着要重新训练。
一个分块应当知道的三个层次
| 层次 | 含义 | 由谁实现 |
|---|---|---|
| 几何 | "我是 8×8 网格中的分块 (3, 5)" | PaDIS 的坐标通道 |
| 视觉 | "整张画面看起来是这样的" | DemoFusion、FreeScale、DC-VSR、ResMaster |
| 语义 | "这是皮肤,旁边是头发,不要凭空画出一只耳朵" | AccDiffusion v2,或每个分块一段 VLM 描述 |
开箱即用的分块 VAE 只提供第零层:像素加一个全局提示词。
对于视觉层次,有两种方法可行:把整张图像的降采样 VAE 潜变量送入第一个卷积层(保留空间结构、颜色和光照),或者用一个 64 维的全局统计向量(平均颜色、曝光、白平衡)来调制每个块中的 AdaLN-Zero。后者开销较小,但不携带空间信息。通过 IP-Adapter 使用 CLIP 图像嵌入效果不佳:一个没有空间轴的向量无法表达"这个分块的上边缘是深蓝色的天空,它的下边缘是淡色的"。
我是测量而非假设的。在 SDXL 上做的一次反事实探针,比较真实预览与随机噪声预览,适配器强度为 0.4,得到每像素的平均差异为 0.0066(最大为 0.26),低于我认为信号是装饰性的 0.02 阈值。图像编码器在每次调用时都会触发,适配器确实在运行,但几乎没有改变任何东西。我四月时的猜测是编码器不匹配:这个适配器是在 bigG ViT 的图像嵌入上训练的,而我们使用的是标准的 SDXL 组合 CLIP-L 与 CLIP-G。
2026 年 9 月更新。 那个猜测至今未经检验。探针记录中还显示出第二个候选原因:整张图以 224×224 像素的形式进入适配器,这本身就限制了它能携带的信息量。
对于语义层次,直接的路径是用 Florence-2 这类 VLM 为每个分块生成一段描述,每个分块约 50 毫秒:一个带有肩膀和头发的分块得到"皮肤和头发,没有毛皮",而一个臆造的毛皮纹理会与它自己的提示词相矛盾。我想尝试的较便宜的变体是为整张图写一段描述,并在每个分块中降低不存在的 token 的权重,使天空分块压低脸部、头发和金属的影响。AccDiffusion v2 以类似的精神,从一个图像提示词构建分块级提示词。这一点我尚未尝试。
综合起来,一个分块的输入是它自己的潜变量、两个坐标通道、整张图的降采样潜变量,以及可选的分割蒙版。新的输入权重必须从零开始初始化。否则在第 0 步,模型看到的是它的正常输入加上随机权重,预训练的行为会在第一次前向传播中被破坏。以零初始化,它一开始就与骨干网络完全相同,然后逐渐学会使用新的通道,这与 ControlNet 中的零卷积是同一个技巧。
# Illustration, not production code: widen a pretrained first convolution
# so each tile can also receive its coordinates and a global preview.
import torch
import torch.nn as nn

def widen_first_conv(conv: nn.Conv2d, extra: int) -> nn.Conv2d:
    new = nn.Conv2d(conv.in_channels + extra, conv.out_channels,
                    conv.kernel_size, conv.stride, conv.padding)
    with torch.no_grad():
        new.weight.zero_()                     # new channels start silent
        new.weight[:, :conv.in_channels] = conv.weight
        new.bias.copy_(conv.bias)
    return new

def coord_channels(box, full_w, full_h, h, w):
    x0, y0, x1, y1 = box                       # tile position in the full image, px
    xs = torch.linspace(x0, x1, w) / full_w * 2 - 1
    ys = torch.linspace(y0, y1, h) / full_h * 2 - 1
    gy, gx = torch.meshgrid(ys, xs, indexing="ij")
    return torch.stack([gx, gy])               # (2, h, w), values in [-1, 1]
看起来像结果的 bug
以下内容于 2026 年 9 月根据当周的项目日志补充。两个 bug 和一次险些发生的失误,比运行本身教会我的更多。
- 不起作用的坐标。 本应添加坐标通道的函数直接返回了原图,而且从未被调用,但它的文档字符串承诺会把坐标拼接进第一个卷积层。一次显式的消融显示差异恰好为 0.0。随后,针对无训练路径的修复——一个依赖位置的色调偏移——又太弱:±1% 约为 255 级中的 2.5 级,低于 JPEG 噪声。于是它提高到 5%,约为 13 级。
- 险些发生:被注意力后端关闭的适配器。 对合并流水线的代码审查发现,在
load_ip_adapter()之后启用了 xformers。如果 xformers 发生回退,它会用普通的注意力处理器替换 IP-Adapter 的注意力处理器,不会报任何错误,适配器就这样不再起作用。审查者认为这种可能性很大(85%);但没有任何运行表明它真的发生过。现在的顺序是先 VAE 分块,再 xformers,最后是适配器,并在之后检查处理器的类别。 - 偶然通过的探针。 第一个 AnimateDiff 探针把 4 维张量的首维读作帧轴。无分类器引导会使该维度翻倍,于是计数结果是分块数的两倍,而探针仍然报告 OK。现在它只读取 5 维张量,因为在那里帧轴才是真实的。
这一教训现在是项目规则:不允许静默的回退,而且每个探针都必须有一个控制模式,它故意破坏该机制,并且必须返回 FAIL。从未见过失败的探针,什么也证明不了。为项目中的十一项验证技术逐一补上控制模式,目前仍未完成。我如何为代理编写此类规则,见 关于我的 CLAUDE.md 的文章。
额外的想法:减少分块,而不是让分块更聪明
一个没有运行支持的假设。Detail Daemon(及其 ComfyUI 移植版)重塑了 sigma 调度,使去噪后期的低噪声步骤增加更多细节,而无需重新训练。
去噪步骤的前半部分处理低频:颜色分布、构图、大的形状。这部分可以在一次通过中、在降采样版本上运行,没有分块,也就没有低频接缝。后半部分增加细节,而 Detail Daemon 是通过调度而不是递归的再去噪来做到这一点的。如果这一点成立,那么一半的步骤既便宜又无接缝,分块只保留在细节阶段,大概在边长超过 2048 之后仍然需要,因为 4096×4096 的注意力图也放不进 80 GB 的显存。节省步数的实验(五种方法,五种步数预算,以拉普拉斯方差、高频能量和频谱斜率来衡量细节)已经写好,但尚未运行。我在生产图中实际使用的分块和频率节点,见 关于自定义 ComfyUI 节点的文章 以及 /comfyui/。
这些都不能证明什么
- 完整的消融尚未完成。 我四月报告的 SANA 运行既不是完整的训练,也不是与基线的比较,而它的日志也不在仓库中。接缝 PSNR、分块边界与内部之间的 ΔE 比率,以及皮肤和头发蒙版上的 HF-SSIM,都还没有测量。
- 我不知道哪种架构会胜出。 SANA 上的块线性注意力应该在显存上占优,缓存的 Klein 在质量上占优,而 SVD 式注意力是最直接的移植。哪一个会在真正的消融中胜出,我不做猜测。
- 我不知道它如何扩展。 所有探针都运行在 3×3 到 7×7 的网格上;一个 100 分块的网格需要 FramePack 式的压缩或滑动窗口。
- 语义层次尚未检验, 而 Detail Daemon 的想法只是一个草图。
2026 年 9 月更新。 这些都没有改变。项目中最后一次实验提交是 4 月 26 日。5 月,我在探针中修复了一个潜在的崩溃,使它在消耗 GPU 时间之前就被发现,并为长时间运行设置了项目:一份功能列表、一份问题日志,以及一道必须通过的语法检查,之后才会租用 GPU。在检查这一更新时,我发现这项工作仍然没有提交、只存在于磁盘上,这违背了我自己的规则:git 应当是唯一的事实来源。下一步与四月相同:一次 GPU 会话,用其探针重新运行每个已修复的假设,然后进行消融。本系列的第二部分尚未发表,代码仓库仍然是私有的。请把以上内容全部当作带有少量早期信号的假设来阅读。
我会做出的不同选择
- 从第一天起就设置负面对照。 上面两个 bug 正是对照运行能立即发现的那一类。
- 在训练之前先看条带。 内容跳变是在前两次微调已经运行之后才被注意到的。
- 每次比较只改变一项。 全局预览方法与基线的首次运行,在采样器、强度、种子、图像尺寸和负面提示词上同时不同,因此它无法说明预览本身的作用。修正办法是把所有这些对齐,并增加一次关闭预览的运行。
俄文原文发表于 Habr。