拡散モデルが4000万画素の写真に継ぎ目を描く理由、そしてタイルに記憶を持たせる方法
著者: Anastasiia Butova, ComfyUI・拡散モデルエンジニア(ベオグラード) · 公開 2026-04-26 · 更新 2026-09-23
英語版からの翻訳: English
プロ向けのレタッチ用ファイルは40〜150メガピクセルあり、拡散モデルは一度に1〜4メガピクセルしか扱えないので、どのパイプラインも写真をタイルに切ります。そこから2つの問題が生じます。タイルの境界で見える段差と、何を見ているのかを知らないモデルです。この記事では、ブレンドで段差が消えない理由、動画拡散のどのメモリの仕組みがフレームからタイルへ移せるか、各タイルがなぜ写真全体と自分の座標を持つべきか、そして最初の実行が何を示したか(失敗も含めて)を扱います。私はレタッチャーとして20年以上働いてきて、このようなファイルで拡散モデルを思いどおりに動かす作業は4年目になります。この作業は、Happyin.ai の背後にある高解像度の img2img の研究に属します。2026年9月に改訂しました。訂正と、その後の結果には、その日付を付けています。
なぜ誰もがタイルに分けるのか
レタッチは、2048ピクセルの一辺では終わりません。Phase One IQ4 は 14200×10600、Hasselblad H6D-100c は 11600×8700、Canon R5 は 8192×5464 を出します。それでも、肌、髪、色、光、背景の作業はすべて必要です。現在のモデルがネイティブに扱えるのは1024〜2048です。SDXL と SANA は1024(SANA はさらに学習されて4K まで)、FLUX と Klein は2048 で許容できる品質です。1024未満では品質が落ち、タイルの数が増えます。
タイルを1024にして小さなオーバーラップを取ると、60 MP のファイルは75〜80タイル、100 MP は約130、150 MP は約190 になります。オーバーラップは継ぎ目を隠しますが、数を何倍にもします。同じ150 MP のファイルは、25%のオーバーラップで約270タイル、50%で約540タイルです。そのため、画像1枚あたり150を超えるタイルは通常のケースで、タイル数の二乗に比例してコストが増える仕組みは、始まる前に使えません。80 GB の VRAM にも、192 GB の VRAM にも収まりません。
ブレンドで継ぎ目が消えない理由
オーバーラップとブレンドが一般的な解決策ですが、ブレンドは周波数によって異なる振る舞いをします。滑らかな内容(空のグラデーション、肌のトーン、金属の反射のなだらかな減衰)では、クロスフェードは色の段差をうまく隠せます。髪、石、粒子、細かい傷では、2つの失敗の仕方のどちらかになります。境界に硬い段差が残るか、テクスチャが滲むかです。オーバーラップの中で、モデルが独立に描いた2つのテクスチャを平均してしまうからです。
滲みには、単純な数字の裏付けがあります。同じコントラストで無相関な2つのテクスチャを50/50で平均すると、コントラストの √0.5、およそ71%が残ります。下の合成図では、オーバーラップの中央で 0.70 を測りました。
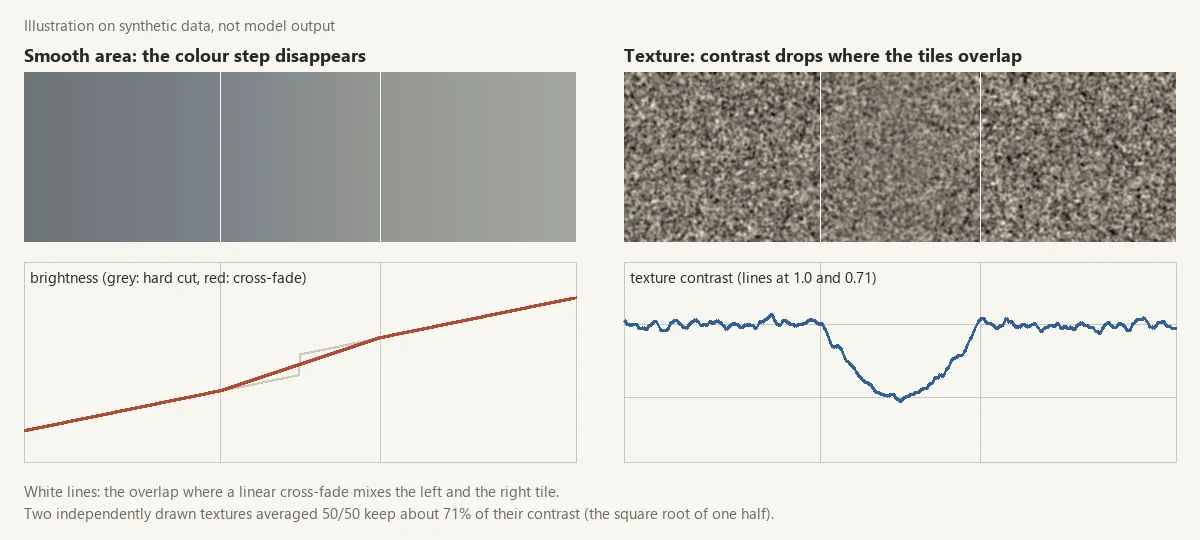
ブレンドを強くするほど、色の継ぎ目は柔らかくなりますが、すべてのタイルの境界に沿ったテクスチャは平坦になります。どちらも1つのつまみでは直せません。そして、色の段差そのものは、タイルが互いに独立に漂うことから来ます。タイル (3, 5) には、タイル (3, 4) がどの色を選んだかが分かりません。
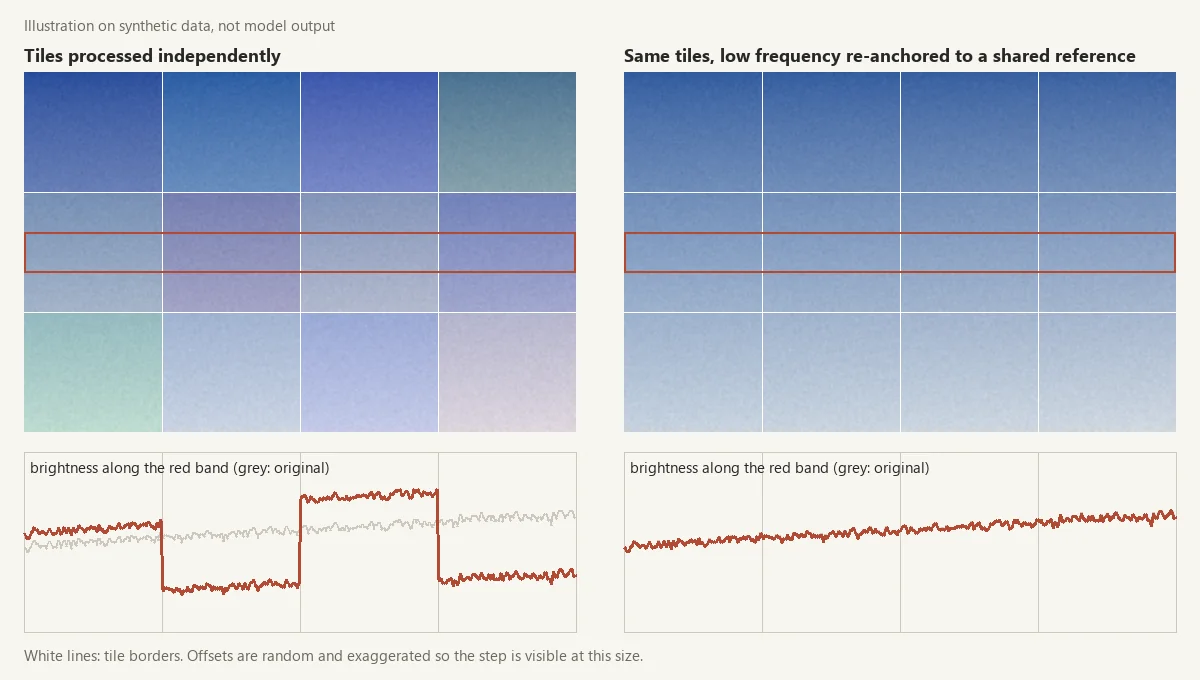
この玩具の例では、タイルの境界での最大の段差は、255段階のうち 18.5 から 0.5 に下がります。ずれは誇張されていますが、この記事の方向性はその原理です。各タイルに、隣と共有する参照を与え、低周波を互いではなく、その参照に対して合わせることです。ResMaster は、生成のためにこれのひとつの版を行っています。デノイズのすべてのステップで、各パッチの低周波成分を、低解像度の参照と揃えます。
タイルのためのメモリの仕組みに必要なこと
- タイル数に対して二乗では増えないコスト。 完全な3Dアテンションは使えません。
- 再学習なしでの利用。 推論だけでの部分的な利用でも、大きな利点です。
- 連続的でピクセル精度の出力。 私たちが扱うのはテクスチャであって、美的なものを生成しているのではありません。FSQ の語彙が 64K の Cosmos のような離散トークンのモデルは、細部を量子化して消してしまいます。
- 取り出せるプリミティブ。 Wan 2.1(14B)と HunyuanVideo(13B)は、長い動画、動きの制御、音声の同期、マルチショットの構成を持っています。その半分は、写真にはない問題を解くためのものです。私はそのすべてに VRAM を払うことになります。SANA-Video、AnimateDiff、SVD、FramePack は、それぞれのメモリのプリミティブを切り出しています。そして、可能な限り Apache 2.0 のものです。交渉なしに、結果を製品に組み込めるようにするためです。
私が選ぶ主な軸は、メモリが終わったタイルをどう忘れるかです。200個のタイルのすべての K/V テンソルが VRAM に残らないように。スライディングウィンドウは、直近のいくつかを保持し、遠くのものは見えません。幾何学的な圧縮は、近傍を全解像度で保持し、遠くのタイルは圧縮して、合計が収束するようにします。蓄積された状態は、タイルを一切保持せず、2つの小さな累積和だけを保持します。
アイデア1:動画モデルはフレームを覚え、写真モデルは覚えない
「写真モデル」とは、通常の画像から画像への拡散モデルのことです。SDXL、FLUX、Klein、SANA などです。動画モデルがフレーム18を生成するとき、フレーム17、16、いくつかの初期のキーフレーム、ときには最初のフレームも見ています。その記憶はアーキテクチャの中にあり(時間軸上のアテンション、蓄積された状態、チャンク間の KV キャッシュ)、それが背景がジッターせず、フレーム間で色がずれない理由です。
タイル (3, 5) を処理する写真モデルは、そのピクセルとテキストのプロンプトを受け取ります。左の隣人も、上の隣人もいません。これが1枚の絵の一部だという考えもありません。記憶を時間軸から空間のグリッドへ移せば、継ぎ目に対処でき(タイルは隣人の色を覚えている)、意味の一部にも対処できます(髪のタイルは、その下から首が始まることを知っていて、毛皮を描かない)。動画の文献には、8つのアーキテクチャの記憶のクラスがありますが、すべてが平面へ移せるわけではありません。
| タイプ | 仕組み | 例 | タイルへの適用 |
|---|---|---|---|
| A · 完全な3Dアテンション | すべてのトークンが、すべてのトークンを見る | Wan | 外す:二乗で増え、64タイル以上では始まらない |
| B · ブロック線形アテンション | 累積和 S = Σ φ(K)ᵀV、Z = Σ φ(K)ᵀ | SANA-Video | 主力:状態は一定 |
| C · スライディングウィンドウ | 直近の W フレームにアテンション | CausVid | 予備:局所的には良いが、遠くのタイルには盲目 |
| D · 空間と時間の分解 | 空間の各層の後に時間の層 | SVD、AnimateDiff | 直接の対応:「すべてのフレームにわたって」が「すべてのタイルにわたって」になる |
| E · アンカーフレーム | すべてのフレームがアンカーにアテンション | Rolling Forcing、StreamingT2V | 追加:アンカーのタイルが色を揃える |
| F · 幾何学的圧縮 | 近いフレームは全密度、遠いものは圧縮 | FramePack | 主力:近傍は全密度、斜めは2倍圧縮、遠くは4倍圧縮 |
| G · キャッシュの共有 | 特徴を一度計算し、ステップをまたいで再利用 | Ca2-VDM | 追加:近傍の特徴を一度だけ計算 |
| H · 離散トークン | FSQ の語彙、次トークン予測 | Cosmos | 外す:連続的なピクセル編集と両立しない |
そのうち3つが重要です。
B、SANA-Video のブロック線形アテンション。 各ブロック(そこではフレーム、ここではタイル)は、そのキーと値を2つのアキュムレーターに加えます。次のブロックは、それ以前のすべてのトークンを見る代わりに、アキュムレーターを読みます。状態はブロック数に対して増えないので、100タイルは10タイルと同じコストです。SANA はすでにすべての層で線形アテンションを使っているので、そのプリミティブはただで手に入ります。
2026年9月の更新。 4月版では、SANA 1.6B のこの状態を約380 MB としていました。それはそのモデルに対しては誤りでした。2,304 は、テキストエンコーダーの埋め込みの幅(
caption_channels)であり、28層は 0.6B モデルのものです。SANA 1.6B は、各ヘッドが32次元の70ヘッドを持つ20層です(config)。その線形アテンションは、ヘッドごとに S と Z を fp32 で保持します(diffusers のSanaLinearAttnProcessor2_0)。それは、ヘッドごとに 33×32 の数、20層すべてで約6 MB です。粗い数え方でも、層ごとに 2,240×2,240 の行列1つを fp16 で、約200 MB になります。結論はより強くなります。状態はタイル数に対して一定で、小さいのです。
D、SVD のような空間と時間の分解。 SVD は、SD 2.1 の UNet の空間の各層の後に、時間の畳み込みとアテンションの層を挿入します。合計 1,521M のパラメータのうち 656M が新しいもので、動画の部分はモデルの 43%です。(ロシア語の原文では SDXL と書いていましたが、SVD の論文は SD 2.1 としています。2026年9月に訂正しました。)機械的には、ただの reshape です。空間のブロックの後で、(B·T, C, H, W) は (B·H·W, T, C) になり、時間のアテンションを通って戻ります。T の位置にタイルの数を置けば、「このピクセルはすべてのフレームでどう見えるか」が「この位置はすべてのタイルでどう見えるか」になります。これは最も文字どおりの移植で、最も壊れやすいだろうと予想していました。AnimateDiff のモーションモジュールも同じ考え方で、すでに学習済みで推論時に使えますが、32フレームに上限があるので、32タイルまでです。
F、FramePack の幾何学的圧縮(ControlNet の作者 Lvmin Zhang)。近いフレームは全密度でコンテキストに入り、遠いものはより強く圧縮され、合計は固定の上限に収束します。タイルでは、(3, 5) は (2, 5)、(3, 4)、(3, 6)、(4, 5) を全密度で見て、斜めは2倍圧縮、遠いタイルは4倍圧縮で見ます。コンテキストは写真の大きさに関係なく同じなので、16×16 のグリッドでも二乗的な爆発なしに動きます。
最も近い既存の研究は、別の方向に進んでいます。PatchVSR は、動画モデルをパッチ単位の超解像に適応させますが、その時間のアテンションは、パッチの内側で、そのパッチのフレームの間だけで行われます。Sliding Tile Attention は、動画 DiT のアテンションを FlashAttention-2 に対して 2.8〜17 倍速くします。スライディングタイルのアイデアはそこから来ましたが、速度の結果です。(4月版では、その 2.8〜17 倍を端から端までの速度としていました。論文ではアテンションの速度です。2026年9月に訂正しました。)FrescoDiffusion(2026年3月)は、最も近い仲間です。4K の画像から動画へのタイル付きのデノイズで、各タイルは、タイムステップごとに低解像度の参照と融合されます。ただし、写真を編集するのではなく、動画を生成します。静止画に対して、動画の時間のアテンションをタイル間のアテンションとして使い、複数のバックボーンで体系的に実験した研究は見つけられませんでした。
隣人のデータセット。タイルのデータセットではない
ほとんど誰も書いていませんが、データセットは仕事の半分です。隣人を覚えることを学ぶには、モデルは隣人の列を見る必要があります。私はストリップを使います。写真を1本の直線の行か列で切り、タイルに分けたものです。
ソースは、手元にあったジュエリーのセット、約52,500枚の写真です。ジュエリーは、素朴なタイル分割が失敗するすべてを凝縮しています。細い縁、屈折、ムラのある影を持つ金属の反射、細かいテクスチャの石です。各写真は3つのスケール(512、768、1024)、3つのオーバーラップ(0%、25%、50%)、4つの方向で切られます。保存するのは左から右と、上から下のストリップだけで、逆向きのものはローダーで np.flip して作ります。逆向きが重要なのは、ブロック線形アテンションが因果的だからです。タイルは、それより前のタイルの累積の要約だけを見ます。左から右だけで学習させると、他の歩き方は一度も見ていないことになります。
紙の上では、写真1枚あたり約70のストリップで、セット全体では300〜400万の例です。パイプラインは、40万本の保存されたストリップで止まるように設計されています。最初のラウンドではタイルを256×256 にリサイズし、元のものは後で切り直すために残します。2026年9月に確認したところ、マニフェストによれば、これまでの1回の実行は100枚の写真から7,368本のストリップを切りました。写真1枚あたり74本で、見積もりに近い数です。
作っているうちに、その週でいちばん有用な観察が得られました。ストリップは、オブジェクトの境界をまたぎます。 ある 5184×3456 の写真で、スケール 512 の4行目は、肌、肌、肌、指先、ブレスレットのビーズ、と続きます。毎秒24〜60フレームでは、連続する動画のフレームは 17〜42 ms 離れ、動きは小さく、オプティカルフローは滑らかです。隣接するタイルは、一歩で肌から金属へ飛びます。タイルの半分の歩幅では、ストリップはゆっくりしたパンのように振る舞います。そして、最終的なセットは3つのオーバーラップすべてを混ぜるので、硬いジャンプから滑らかなパンまでが含まれます。
4月に実行したこと
元の投稿の時点では、SANA だけでした。SANA は 512 で学習され、その後 1024、2K、4K で学習されているので、1024 のタイルはネイティブで、線形アテンションはすでにバックボーンに入っています。テストのストリップ、タイル 1024 で小さな学習を実行し、2つの問いを立てました。損失は収束するか。そして、この仕組みは時間軸から平面へ移るのか。損失は収束し、モデルは、隣接するフレームを調整していたのと同じように、隣接するタイルを調整することを学びました。私は、テストの実行から得た数字を公表したことはなく、今も公表していません。
2026年9月の更新。 プロジェクトのリポジトリを読み直したところ、その SANA の学習のログは見つかりませんでした。そこに保存されている損失の曲線は、他の2つの移植のものです。したがって、上の SANA の文は、私の4月の報告として扱ってください。証拠としてではありません。その週の実行メモに残っていることは次のとおりです。推論で、SANA の蓄積された状態をオンにすると、出力は平均 19.5 段階(255段階中)変わりました。健全性チェックが止まるのは 0.5 未満のときです。その仕組みは、サイレントな無操作ではないということです。これは「より良い」とは程遠いものです。他の2つの移植は、1024 px 以上の約7,000枚の写真から作ったタイルのシーケンスで微調整されました。SDXL に SVD スタイルのアテンションをタイル間に入れたもの:損失の100ステップ移動平均は約40%下がり、予測には認識できる構造がありましたが、タイルの格子に揃った斜めのモアレがありました。私はこれを、実装がタイルをまたいでキーと値を平均プーリングしていることによると考えています。SD 1.5 の AnimateDiff のモーションモジュール:重みは変わりました(更新のフロベニウスノルムは 15.28)が、微調整の前と後の出力はほぼ同じに見えました。メモは、損失がどれだけ下がったかについて互いに食い違っているので、その数字は載せません。私はこの同一の出力を、タイルに対するモーションモジュールの否定的な結果と読みました。作業上の説明は、上で述べたストリップの飛びです。モジュールは滑らかな動きの事前知識を持っていて、写真はそれを満たさないのです。どちらも学習が不十分なスナップショットなので、数字は下限であって、結果ではありません。
アイデア2:各タイルに、写真全体と位置を与える
6000×4000 の写真をタイルに切るとき、写真全体を手元に持っているのに、使わないのは不自然です。潜在空間で全体を縮小し、すべてのタイルに、追加のチャンネルとして最初の畳み込みに入れます。さらに、タイルの位置を2つのチャンネル (x, y) ∈ [−1, 1] として加えます。そうすると、タイル (3, 5) は、自分が (3, 5) であること、そして虚空に浮かぶただの 512 ピクセルではないことを知ります。PatchVSR は、動画の超解像でこの両方を行っています。グローバルな分岐がリサイズした動画全体を見て、パッチの位置がモデルに注入されます。
位置の価値:PaDIS
PaDIS(Hu ら、NeurIPS 2024)は、パッチだけで拡散の事前分布を学習し、すべてのパッチに2つの位置の配列を連結します。全体画像の中の各ピクセルの x と y の座標を [−1, 1] に正規化したものです。それにはノイズを加えません。彼らの付録のアブレーション(表6、CT 再構成)ははっきりしています。位置ありで PSNR 33.57 dB、位置なしで 23.25 dB、位置なしでベースラインの再構成から初期化しても 24.51 dB です。著者たちは、ネットワークがパッチベースの事前分布を「完全に学習できなかった」と書いています。10デシベルの差は、動くことと動かないことの差です。
この数字を借りる前に、2つの注意があります。それは CT で、写真ではなく、パッチから最初から学習させたピクセル空間のモデルです。事前学習済みの潜在モデルに、40 MP のレタッチで座標が何を加えるかは、誰も測定していません。その実験は、私のリストの最初の項目で、まだ終わっていません。
なぜ重要かは見ればわかります。位置がなければ、1つの関数がすべてのパッチを、場所と知識を結びつける方法なしに復元しなければなりません(「顔は普通ここにあり、空のグラデーションはあそこにある」)。そのため平均化してしまい、その平均はノイズに見えます。ピクセルごとに2つの数字なら、ほぼ何のコストもかかりません。ほとんどのタイル分割パイプラインがそれを入れていないのは、おそらく、事前学習済みのモデルには固定の入力幅があり、チャンネルを増やすたびに学習が必要になるからです。
タイルが知るべき3つのレベル
| レベル | 意味 | 担当 |
|---|---|---|
| 幾何学的 | 「私は 8×8 グリッドのタイル (3, 5) だ」 | PaDIS の座標チャンネル |
| 視覚的 | 「写真全体はこういう見た目だ」 | DemoFusion、FreeScale、DC-VSR、ResMaster |
| 意味的 | 「これは肌で、隣には髪がある。耳を勝手に作るな」 | AccDiffusion v2、タイルごとの VLM のキャプション |
標準のタイル分割された VAE は、そのままでは0番目のレベルだけを持ちます。ピクセルと、1つのグローバルなプロンプトだけです。
視覚的なレベルでは、2つのことがうまくいきます。写真全体のダウンスケールした VAE 潜在を、最初の畳み込みに入れる方法(空間構造、色、光を保つ)、あるいは全体の統計量(平均色、露出、ホワイトバランス)の64次元のベクトルを、すべてのブロックの AdaLN-Zero で変調する方法です。後者は安いですが、空間情報は持ちません。IP-Adapter を通した CLIP の画像埋め込みは、うまく働きません。空間の軸を持たないベクトルは、「このタイルの上端は暗い青の空、下端は淡い色」とは言えないからです。
私はそれを仮定ではなく、測定しました。SDXL で反事実的なプローブを行いました。実際のプレビューとランダムノイズのプレビューを、アダプターのスケール 0.4 で比べると、ピクセルあたりの平均差は 0.0066(最大 0.26)でした。私が信号を飾りと呼ぶ 0.02 のしきい値を下回ります。画像エンコーダーはすべての呼び出しで発火するので、アダプターは走っていますが、ほぼ何も変えていません。4月の私の推測は、エンコーダーの不一致でした。アダプターは bigG の ViT の画像埋め込みで学習されていますが、セットアップは標準の SDXL のペアである CLIP-L と CLIP-G を使っていました。
2026年9月の更新。 その推測は、今もテストされていません。プローブの記録には、2つ目の候補があります。写真全体は、224×224 のピクセルとしてアダプターに届いていて、それだけで、運べる情報を制限してしまうのです。
意味的なレベルについては、直接の経路は、Florence-2 のような VLM によるタイルごとのキャプションで、タイル1つあたり約50 ms です。肩と髪のあるタイルには「肌と髪、毛皮はなし」というキャプションが付き、幻覚の毛皮のテクスチャは、そのタイル自身のプロンプトと矛盾します。私が試したい安い変種は、写真全体に1つの説明を付け、各タイルでは不在のトークンの重みを下げることです。そうすると、空のタイルは顔、髪、金属をミュートします。AccDiffusion v2 は、1つの画像のプロンプトから、似た精神でパッチレベルのプロンプトを作ります。私の側ではまだ試していません。
まとめると、タイルの入力は、自分自身の潜在、2つの座標チャンネル、写真全体のダウンスケールした潜在、そして任意でセグメンテーションのマスクです。新しい入力の重みは、ゼロで初期化しなければなりません。さもないと、ステップ0で、モデルは通常の入力とランダムな重みを見てしまい、事前学習済みの振る舞いが最初のフォワードパスで壊れます。ゼロ初期化すると、バックボーンとまったく同じところから始まり、新しいチャンネルを少しずつ使うことを学びます。ControlNet のゼロ畳み込みと同じ仕掛けです。
# Illustration, not production code: widen a pretrained first convolution
# so each tile can also receive its coordinates and a global preview.
import torch
import torch.nn as nn

def widen_first_conv(conv: nn.Conv2d, extra: int) -> nn.Conv2d:
    new = nn.Conv2d(conv.in_channels + extra, conv.out_channels,
                    conv.kernel_size, conv.stride, conv.padding)
    with torch.no_grad():
        new.weight.zero_()                     # new channels start silent
        new.weight[:, :conv.in_channels] = conv.weight
        new.bias.copy_(conv.bias)
    return new

def coord_channels(box, full_w, full_h, h, w):
    x0, y0, x1, y1 = box                       # tile position in the full image, px
    xs = torch.linspace(x0, x1, w) / full_w * 2 - 1
    ys = torch.linspace(y0, y1, h) / full_h * 2 - 1
    gy, gx = torch.meshgrid(ys, xs, indexing="ij")
    return torch.stack([gx, gy])               # (2, h, w), values in [-1, 1]
結果のように見えたバグ
2026年9月に、その週のプロジェクトのログから追加しました。2つのバグと、1つの紙一重の事例が、実行結果よりも多くを教えてくれました。
-
何もしなかった座標。 座標チャンネルを加える関数は、画像をそのまま返し、呼び出されてもいませんでした。その docstring は、最初の畳み込みへの連結を約束していました。明示的なアブレーションでは、差はちょうど 0.0 でした。学習なしの経路のための修正、位置に依存する色味は、±1%では弱すぎました。それは 255段階のうち約2.5段階で、JPEG のノイズより小さいのです。そのため、5%、約13段階に上げました。
-
紙一重の事例:アテンションのバックエンドによって無効化されたアダプター。 組み合わせたパイプラインのコードレビューで、
load_ip_adapter()の後に xformers が有効になっていることが見つかりました。xformers がフォールバックすると、IP-Adapter のアテンションのプロセッサーが、素のものに置き換わります。エラーは出ず、アダプターは単に何の効果もなくなります。レビュアーは可能性が高い(85%)と評価しました。しかし、実行で起きたことを示すものはありませんでした。今は順序が、VAE のタイル分割、xformers、アダプターです。その後、プロセッサーのクラスを確認します。 -
偶然に通ったプローブ。 AnimateDiff の最初のプローブは、4次元のテンソルの先頭の次元を、フレームの軸として読んでいました。クラシファイアフリーのガイダンスがその次元を2倍にするので、数はタイル数の2倍になり、プローブは OK と言いました。今は5次元のテンソルだけを読みます。そこではフレームの軸が本物だからです。
教訓は、今ではプロジェクトのルールです。黙ったフォールバックはしない。すべてのプローブには、仕組みを意図的に壊す制御モードがあり、それが FAIL を返さなければならない。一度も失敗するのを見たことのないプローブは、何も証明しません。プロジェクトの11の検証の手法それぞれに制御モードを後付けすることは、まだ終わっていません。このようなルールをエージェントのために書く方法は、私の CLAUDE.md についての記事にあります。
おまけのアイデア:賢いタイルではなく、少ないタイル
裏付けのない仮説です。Detail Daemon(とその ComfyUI への移植)は、シグマのスケジュールを作り直し、後半の低ノイズのステップがより多くの細部を加えるようにします。再学習は不要です。
デノイズのステップの前半は低周波を扱います。色の分布、構図、大きな形です。これは、タイルも低周波の継ぎ目もなく、ダウンスケールしたバージョンで一度のパスで行えるかもしれません。後半は細部を加えますが、Detail Daemon は、再帰的な再デノイズではなく、スケジュールを通してそれをします。もし成り立つなら、ステップの半分は安く、継ぎ目がありません。タイル分割が残るのは細部の段階だけで、おそらく2048 の一辺より上では今も必要です。4096×4096 のアテンションマップは、80 GB にも収まらないからです。ステップを節約する実験(5つの手法を、5つのステップ予算で、Laplacian の分散、高周波のエネルギー、スペクトルの傾きで細部を測定)は書いてあり、まだ実行していません。本番のグラフで私が実際に使っているタイリングと周波数のノードは、カスタム ComfyUI ノードについての記事と /comfyui/ にあります。
何が証明されていないか
- 完全なアブレーションは終わっていません。 4月に報告した SANA の実行は、完全な学習でもベースラインとの比較でもなく、そのログもリポジトリにありません。継ぎ目の PSNR、タイルの境界と内部の ΔE 比、肌と髪のマスクでの HF-SSIM は、測定されていません。
- どのアーキテクチャが勝つかは分かりません。 SANA のブロック線形アテンションは、メモリでは勝つはずで、キャッシュされた Klein は品質で勝つはずです。SVD スタイルのアテンションは、最も直接的な移植です。本当のアブレーションでどれが勝つかは、推測しません。
- どうスケールするかは分かりません。 すべてのプローブは、3×3 から 7×7 のグリッドで走りました。100タイルのグリッドには、FramePack スタイルの圧縮か、スライディングウィンドウが必要です。
- 意味的なレベルは未テストです。 Detail Daemon のアイデアは、スケッチにすぎません。
2026年9月の更新。 これらのどれも変わっていません。プロジェクトの最後の実験のコミットは4月26日です。5月には、GPU 時間を無駄にする前に、プローブに潜んでいたクラッシュを1つ直し、長い実行のためにプロジェクトを整えました。機能のリスト、問題のログ、そして GPU を借りる前に通らなければならない構文のゲートです。ただし、このアップデートを確認していて、その作業がまだディスク上でコミットされずに残っていることに気づきました。これは、git を真実の源とする私自身のルールに反します。次の一手は4月と同じです。1回の GPU のセッションで、修正済みのすべての仮説を、そのプローブとともに再実行し、そのあとアブレーションを行います。この連載の第2部はまだ公開されておらず、コードのリポジトリも今も非公開です。上のすべては、いくつかの初期のシグナルを持つ仮説として読んでください。
今ならやり直すこと
- 初日から否定的な制御を。 上の2つのバグは、制御の実行がすぐに捕まえる種類のものです。
- 学習の前に、ストリップを見る。 内容の飛びは、最初の2回の微調整がすでに走ったあとに気づきました。
- 比較ごとに変更は1つだけ。 大域的なプレビューの方法と、ベースラインの最初の実行は、サンプラー、強さ、シード、画像サイズ、ネガティブプロンプトが同時に違っていました。そのため、プレビューについては何も言えませんでした。修正は、すべてを揃え、プレビューをオフにした実行を追加することでした。
ロシア語の原文は Habr に掲載されました。