Por qué la difusión dibuja costuras en fotos de 40 megapíxeles, y cómo dar memoria a los tiles
Autora: Anastasiia Butova, ingeniera de ComfyUI y modelos de difusión, Belgrado · publicado 2026-04-26 · actualizado 2026-09-23
Traducción de la versión en inglés: English
Un archivo profesional de retoque tiene entre 40 y 150 megapíxeles, y un modelo de difusión trabaja con uno a cuatro a la vez, así que cada pipeline corta la foto en tiles. Eso trae dos problemas: un escalón visible en los bordes de los tiles y un modelo que no tiene idea de lo que está mirando. Este post cubre por qué la mezcla no puede eliminar el escalón, qué mecanismos de memoria de la difusión de vídeo se trasladan de los fotogramas a los tiles, por qué cada tile debería recibir la imagen completa y sus propias coordenadas, y qué mostraron mis primeras pruebas, incluidos los fallos. Trabajé como retocadora durante más de veinte años y estoy en mi cuarto año haciendo que la difusión se comporte con archivos como estos; el trabajo pertenece a la investigación de img2img de alta resolución detrás de Happyin.ai. Revisado en septiembre de 2026: las correcciones y los resultados posteriores llevan esa fecha.
Por qué todos cortan en tiles
El retoque no vive en 2048 píxeles por lado. Una Phase One IQ4 da 14200×10600, una Hasselblad H6D-100c 11600×8700, una Canon R5 8192×5464, y todo eso sigue necesitando trabajo de piel, pelo, color, luz y fondo. Los modelos actuales son nativos entre 1024 y 2048: SDXL y SANA a 1024 (SANA se entrenó después hasta 4K), FLUX y Klein de forma aceptable a 2048. Por debajo de 1024 la calidad baja y el número de tiles crece.
Con tiles de 1024 y un solapamiento pequeño, un archivo de 60 MP son 75–80 tiles, 100 MP unos 130, 150 MP unos 190. El solapamiento es lo que oculta las costuras, y multiplica el número: el mismo archivo de 150 MP son unos 270 tiles con un 25 % de solapamiento y unos 540 con un 50 %. Así que 150 o más tiles por imagen es un caso de trabajo normal, y cualquier mecanismo cuyo coste crezca con el cuadrado del número de tiles queda descartado antes de empezar. No cabe en 80 GB de VRAM, y tampoco en 192 GB.
Por qué la mezcla no puede eliminar las costuras
El solapamiento más la mezcla es el arreglo habitual, y la mezcla se comporta de forma distinta según la frecuencia. En contenido suave (un degradado de cielo, un tono de piel, una caída suave en un reflejo sobre metal) un fundido cruzado oculta bien un escalón de color. En pelo, piedra, grano o arañazos finos falla de una de dos maneras: se queda un escalón duro en el borde, o la textura se emborrona, porque dentro del solapamiento promedias dos texturas que el modelo dibujó por separado.
El emborronado tiene un número simple detrás. Dos texturas no correlacionadas de igual contraste, promediadas al 50/50, conservan √0,5 de su contraste, alrededor del 71 %. En la ilustración sintética de abajo medí 0,70 en el centro del solapamiento.
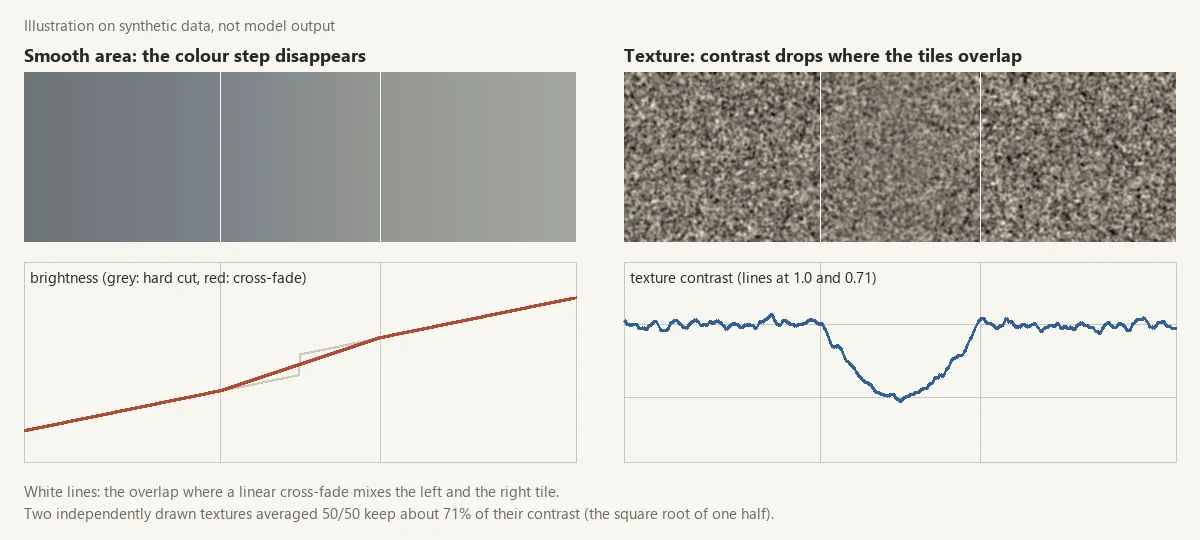
Un solo control no puede arreglar las dos cosas: cuanto más mezclas, más suave es la costura de color y más plana la textura a lo largo de cada borde de tile. Y el escalón de color en sí procede de tiles que derivan de forma independiente. Nada le dice al tile (3, 5) qué color eligió el tile (3, 4).
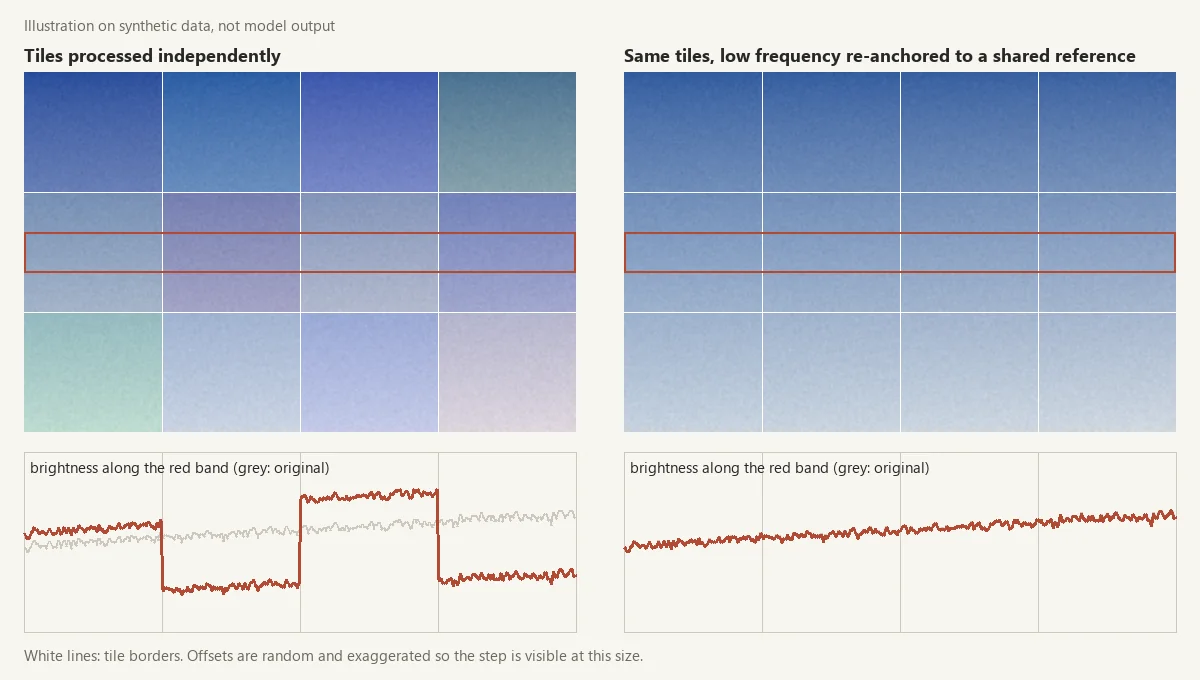
En este juguete, el mayor escalón en un borde de tile baja de 18,5 niveles de 255 a 0,5. Los desplazamientos están exagerados, pero el principio es la dirección de todo este post: dale a cada tile una referencia que comparta con sus vecinos, y ajusta las bajas frecuencias contra esa referencia en lugar de contra los demás. ResMaster hace una versión de esto para la generación, alineando las componentes de baja frecuencia de cada parche con una referencia de baja resolución en cada paso de eliminación de ruido.
Lo que debe hacer un mecanismo de memoria para tiles
- Un coste que no crezca cuadráticamente con el número de tiles. La atención 3D completa queda descartada.
- Algún uso sin reentrenar. Incluso un uso parcial solo en inferencia es una gran ventaja.
- Salida continua y precisa al píxel. Retocamos textura, no generamos una estética. Los modelos de tokens discretos como Cosmos, con su vocabulario FSQ de 64K, cuantizan el detalle fino.
- Una primitiva que pueda extraer. Wan 2.1 (14B) y HunyuanVideo (13B) llevan vídeo largo, control de movimiento, sincronía de audio y composición de varias tomas; la mitad de eso resuelve problemas que una foto no tiene, y pagaría todo ello en VRAM. SANA-Video, AnimateDiff, SVD y FramePack aíslan cada uno su primitiva de memoria. Y Apache 2.0 siempre que sea posible, para que el resultado pueda entrar en un producto sin negociación.
El eje principal por el que elijo es cómo olvida un mecanismo los tiles terminados, para que 200 de ellos no se queden en VRAM con todos sus tensores K/V. Una ventana deslizante conserva los últimos y es ciega a todo lo lejano. La compresión geométrica conserva los vecinos a resolución completa y los tiles lejanos comprimidos, de modo que el total converge. El estado acumulado no conserva ningún tile, solo dos sumas acumuladas pequeñas.
Idea uno: los modelos de vídeo recuerdan fotogramas, los de foto no
Por "modelo de foto" me refiero a un modelo ordinario de imagen a imagen por difusión: SDXL, FLUX, Klein, SANA. Cuando un modelo de vídeo genera el fotograma 18, también ve el 17, el 16, algunos fotogramas clave tempranos, a veces el primero. Esa memoria vive en la arquitectura (atención sobre el eje temporal, un estado acumulado, una caché KV entre bloques), y es la razón de que los fondos no tiemblen y el color no derive entre fotogramas.
Un modelo de foto que procesa el tile (3, 5) recibe sus píxeles y un prompt de texto. Ningún vecino a la izquierda, ninguno arriba, ninguna idea de que esto es una sola imagen. Si mueves la memoria del eje temporal a la cuadrícula espacial, abordas las costuras (los tiles recuerdan el color de sus vecinos) y parte de la semántica (el tile del pelo sabe que debajo empieza un cuello, no pelaje). La literatura de vídeo tiene ocho clases arquitectónicas de memoria, y no todas sobreviven al paso a un plano:
| tipo | mecanismo | ejemplos | para tiles |
|---|---|---|---|
| A · atención 3D completa | cada token ve cada token | Wan | descartar: cuadrático, no arranca con 64+ tiles |
| B · atención lineal por bloques | sumas acumuladas S = Σ φ(K)ᵀV, Z = Σ φ(K)ᵀ | SANA-Video | principal: estado constante |
| C · ventana deslizante | atender a los últimos W fotogramas | CausVid | respaldo: bueno localmente, ciego a los tiles lejanos |
| D · espacio y tiempo factorizados | capas temporales tras cada capa espacial | SVD, AnimateDiff | mapeo directo: "a través de todos los fotogramas" pasa a "a través de todos los tiles" |
| E · fotograma ancla | cada fotograma atiende a un ancla | Rolling Forcing, StreamingT2V | complemento: un tile ancla alinea el color |
| F · compresión geométrica | fotogramas cercanos completos, los lejanos comprimidos | FramePack | principal: vecinos completos, diagonales 2×, lejanos 4× |
| G · compartición de caché | características calculadas una vez, reutilizadas entre pasos | Ca2-VDM | complemento: calcular las características de los vecinos una vez |
| H · tokens discretos | vocabulario FSQ, predicción del siguiente token | Cosmos | descartar: incompatible con la edición continua de píxeles |
Tres de ellos importan.
B, atención lineal por bloques de SANA-Video. Cada bloque (un fotograma allí, un tile aquí) añade sus claves y valores a dos acumuladores, y el bloque siguiente lee de los acumuladores en lugar de leer de cada token anterior. El estado no crece con el número de bloques, así que cien tiles cuestan lo que diez. SANA ya usa atención lineal en cada capa, así que la primitiva está disponible gratis.
Actualización, septiembre de 2026. La versión de abril situaba ese estado en unos 380 MB para SANA 1.6B, usando un ancho de 2.304 y 28 capas. Ambas cifras estaban mal para ese modelo: 2.304 es el ancho de los embeddings del codificador de texto (
caption_channels), y 28 capas pertenecen al modelo de 0,6B. SANA 1.6B tiene 20 capas de 70 cabezas de 32 dimensiones cada una (configuración), y su atención lineal guarda S y Z por cabeza, en fp32 (SanaLinearAttnProcessor2_0en diffusers). Eso son 33×32 números por cabeza, unos 6 MB para las 20 capas. Incluso un cálculo grosero, una matriz de 2.240×2.240 por capa en fp16, da unos 200 MB. La conclusión se refuerza: el estado es constante en el número de tiles, y pequeño.
D, espacio y tiempo factorizados, como en SVD. SVD inserta capas temporales de convolución y atención tras cada capa espacial de una UNet de SD 2.1: 656M parámetros nuevos sobre 1.521M, así que la parte de vídeo es el 43 % del modelo. (El original en ruso decía SDXL; el artículo de SVD dice SD 2.1. Corregido en septiembre de 2026.) Mecánicamente es un reshape: tras un bloque espacial, (B·T, C, H, W) se convierte en (B·H·W, T, C), pasa por atención temporal y vuelve. Pon el número de tiles en lugar de T, y "cómo se ve este píxel en cada fotograma" pasa a ser "cómo se ve esta posición en cada tile". Es el port más literal, y esperaba que fuera el más frágil. Los módulos de movimiento de AnimateDiff son la misma idea, ya entrenados y utilizables en inferencia, pero limitados a 32 fotogramas, así que a 32 tiles.
F, compresión geométrica de FramePack (Lvmin Zhang, autor de ControlNet). Los fotogramas cercanos entran en el contexto a plena densidad, los lejanos más comprimidos, de modo que el total converge a un límite fijo. Para tiles: (3, 5) ve (2, 5), (3, 4), (3, 6) y (4, 5) a plena densidad, las diagonales con compresión 2×, los tiles lejanos con 4×. El contexto se mantiene igual sea cual sea el tamaño de la foto, así que las cuadrículas de 16×16 funcionan sin la explosión cuadrática.
Los trabajos más cercanos van en direcciones vecinas. PatchVSR adapta un modelo de vídeo a superresolución por parches, pero su atención temporal se queda dentro de un parche, a través de los fotogramas de ese parche. Sliding Tile Attention acelera la atención en DiT de vídeo entre 2,8 y 17 veces frente a FlashAttention-2; la idea de tiles deslizantes sale de ahí, pero es un resultado de velocidad. (El texto de abril decía que ese rango era de extremo a extremo; en el artículo es para la atención. Corregido en septiembre de 2026.) FrescoDiffusion (marzo de 2026) es el primo más cercano: eliminación de ruido por tiles para imagen a vídeo en 4K, cada tile fusionado con una referencia de baja resolución en cada paso temporal. Genera vídeo en lugar de editar una foto. No encontré ningún experimento sistemático que use la atención temporal de vídeo como atención entre tiles para una imagen fija, a través de varias arquitecturas.
Un conjunto de datos de vecinos, no de tiles
Casi nadie escribe sobre el conjunto de datos, y es la mitad de la tarea. Para aprender a recordar vecinos, el modelo tiene que ver secuencias de vecinos. Uso tiras: una fila o columna recta a través de una foto, cortada en tiles.
La fuente es un conjunto de joyería que tenía a mano, unas 52.500 fotos. La joyería concentra todo aquello en lo que falla el teselado ingenuo: bordes finos, refracción, metal reflectante con sombras irregulares, piedras con textura fina. Cada foto se corta en tres escalas (512, 768, 1024), con tres solapamientos (0 %, 25 %, 50 %), en cuatro direcciones. Solo se guardan las tiras de izquierda a derecha y de arriba abajo; las invertidas salen de np.flip en el cargador. La inversión importa para la atención lineal por bloques, porque es causal: un tile solo ve el resumen corriente de los tiles anteriores, y si se entrena solo de izquierda a derecha, nunca ha visto ningún otro recorrido.
Sobre el papel son unas 70 tiras por foto y entre 3 y 4 millones de ejemplos para todo el conjunto. El pipeline está diseñado para parar en 400.000 tiras almacenadas, con los tiles redimensionados a 256×256 para la primera ronda y los originales guardados para un recorte posterior. Comprobado en septiembre de 2026: según su manifiesto, la única ejecución hecha hasta ahora cortó 7.368 tiras de 100 fotos, 74 por foto, cerca de la estimación.
Construirlo dio la observación más útil de la semana: las tiras cruzan los límites de los objetos. En una foto de 5184×3456, la fila 4 a escala 512 va piel, piel, piel, punta de dedo, cuentas de pulsera. A 24 o 60 fotogramas por segundo, los fotogramas de vídeo consecutivos están separados 17 a 42 ms, con poco movimiento y un flujo óptico suave; los tiles vecinos saltan de la piel al metal de un paso. Un paso de medio tile hace que una tira se comporte como un paneo lento, y el conjunto final mezcla los tres solapamientos, desde saltos bruscos hasta paneos suaves.
Lo que ejecuté en abril
En ese momento, solo SANA. Se entrenó a 512, luego a 1024, 2K y 4K, así que un tile de 1024 es nativo, y la atención lineal ya está en el backbone. Hice un pequeño entrenamiento con tiras de prueba a tile 1024 con dos preguntas: ¿converge la pérdida?, y ¿se traslada el mecanismo del eje temporal al plano espacial? La pérdida convergió, y el modelo aprendió a reconciliar tiles vecinos del mismo modo que antes reconciliaba fotogramas vecinos. No publiqué números de una prueba y todavía no lo hago.
Actualización, septiembre de 2026. Al releer el repositorio del proyecto, no encontré ningún registro de aquel entrenamiento con SANA en él; las curvas de pérdida que guarda pertenecen a otros dos ports. Así que trata la frase de SANA de arriba como mi informe de abril, no como evidencia. Lo que sí contienen las notas de ejecución de esa semana: en inferencia, al activar el estado acumulado de SANA, la salida cambió en una media de 19,5 niveles de 255, cuando la comprobación de cordura se detiene por debajo de 0,5. El mecanismo no es un no-op silencioso, lo que es mucho menos que "mejor". Los otros dos ports se ajustaron con secuencias de tiles de un conjunto aparte de unas 7.000 fotos de 1024 px o más. SDXL con atención al estilo SVD entre tiles: la media móvil de 100 pasos de la pérdida bajó un 40 % aproximadamente, y las predicciones tenían una estructura reconocible pero un moiré diagonal alineado con la cuadrícula de tiles, que atribuyo a la forma en que mi implementación promedia claves y valores entre tiles. Módulos de movimiento de AnimateDiff sobre SD 1.5: los pesos cambiaron (norma de Frobenius de la actualización 15,28), y sin embargo las salidas antes y después del ajuste fino se veían casi idénticas. Las notas no concuerdan entre sí sobre cuánto bajó esa pérdida, así que dejo el número fuera. Interpreto las salidas idénticas como un resultado negativo para los módulos de movimiento sobre tiles, y mi explicación de trabajo son los saltos de contenido de arriba: los módulos llevan un prior de movimiento suave que las fotos no cumplen. Ambos eran instantáneas subentrenadas, así que las cifras son una cota inferior, no un resultado.
Idea dos: dar a cada tile la imagen completa y su posición
Si cortas una foto de 6000×4000 en tiles, tienes la imagen entera en la mano, y no usarla es extraño. Redúcela en el espacio latente y pásala con cada tile como canales extra en la primera convolución. Añade la posición del tile como dos canales más, (x, y) ∈ [−1, 1], para que el tile (3, 5) sepa que es el (3, 5) y no algún punto de 512 píxeles en el vacío. PatchVSR hace ambas cosas para superresolución de vídeo: una rama global ve el vídeo completo redimensionado, y la ubicación del parche se inyecta en el modelo.
Lo que aporta la posición: PaDIS
PaDIS (Hu et al., NeurIPS 2024) entrena un prior de difusión solo con parches y concatena a cada parche dos matrices posicionales: las coordenadas x e y de cada píxel en la imagen completa, escaladas a [−1, 1], sin ruido añadido. La ablación de su apéndice (Tabla 6, reconstrucción de TC) es tajante: 33,57 dB de PSNR con posición, 23,25 dB sin ella, y 24,51 dB sin posición incluso inicializando desde una reconstrucción de referencia. Los autores escriben que la red "completely failed to learn the patch-based prior". Diez decibelios es la diferencia entre funcionar y no funcionar.
Dos advertencias antes de tomar prestada esa cifra. Es TC, no fotografías, y un modelo de espacio de píxeles entrenado desde cero con parches. Nadie ha medido qué aportan las coordenadas a un modelo latente preentrenado en retoque de 40 MP; ese experimento es el primero de mi lista y no está hecho.
Por qué importa se ve fácilmente. Sin posición, una sola función tiene que restaurar cada parche sin ninguna forma de vincular el conocimiento a un lugar ("las caras suelen estar aquí, el degradado del cielo allí"), así que promedia, y el promedio parece ruido. Dos números por píxel cuestan casi nada, y casi ningún pipeline de tiles los alimenta, probablemente porque un modelo preentrenado tiene un ancho de entrada fijo y cada canal extra significa reentrenar.
Tres niveles de lo que debe saber un tile
| nivel | significado | quién lo hace |
|---|---|---|
| geométrico | "soy el tile (3, 5) de una cuadrícula de 8×8" | canales de coordenadas de PaDIS |
| visual | "la imagen completa se ve así" | DemoFusion, FreeScale, DC-VSR, ResMaster |
| semántico | "esto es piel, al lado hay pelo, no inventes una oreja" | AccDiffusion v2, una descripción de VLM por tile |
El VAE en mosaico, tal cual, da el nivel cero: píxeles y un único prompt global.
Para el nivel visual funcionan dos cosas: un latente de VAE de la imagen completa reducido, dentro de la primera convolución (conserva la estructura espacial, el color, la iluminación), o un vector de 64 dimensiones con estadísticas globales (color medio, exposición, balance de blancos) que modula AdaLN-Zero en cada bloque, que es más barato pero no lleva información espacial. Un embedding de imagen CLIP a través de IP-Adapter no funciona bien: un vector sin ejes espaciales no puede decir "el borde superior de este tile es azul oscuro de cielo, el inferior es pálido".
Lo medí en lugar de suponerlo. Una sonda contrafactual sobre SDXL, vista previa real frente a una vista previa de ruido aleatorio con escala de adaptador 0,4, dio una diferencia media de 0,0066 por píxel (máximo 0,26), por debajo del umbral de 0,02 por debajo del cual llamo decorativa a una señal. El codificador de imágenes se dispara en cada llamada, así que el adaptador se ejecuta y apenas cambia nada. Mi suposición en abril fue un desajuste de codificador: el adaptador se había entrenado con embeddings de imagen ViT de bigG, mientras la configuración usaba el par estándar de SDXL, CLIP-L y CLIP-G.
Actualización, septiembre de 2026. Esa suposición sigue sin probarse. El registro de la sonda muestra un segundo candidato: la imagen completa llega al adaptador como píxeles de 224×224, lo que por sí solo limita lo que puede transportar.
Para el nivel semántico, la vía directa es una descripción por tile de un VLM como Florence-2, unos 50 ms por tile: un tile con hombro y pelo recibe "piel y pelo, sin pelaje", y una textura de pelaje alucinada contradice su propio prompt. La variante más barata que quiero probar es una sola descripción para toda la imagen, con el peso de los tokens ausentes reducido en cada tile, de modo que el tile del cielo silencie la cara, el pelo y el metal. AccDiffusion v2 construye prompts a nivel de parche a partir de un prompt de imagen en un espíritu parecido. Sin probar por mi parte.
Juntando todo, la entrada de un tile es su propio latente, dos canales de coordenadas, el latente reducido de la imagen completa y una máscara de segmentación opcional. Los nuevos pesos de entrada deben empezar en cero. Si no, en el paso cero el modelo ve su entrada normal más pesos aleatorios, y el comportamiento preentrenado se rompe en el primer pase hacia delante. Con inicialización a cero empieza idéntico al backbone y aprende a usar los canales nuevos poco a poco, el mismo truco que las convoluciones cero de ControlNet.
# Illustration, not production code: widen a pretrained first convolution
# so each tile can also receive its coordinates and a global preview.
import torch
import torch.nn as nn

def widen_first_conv(conv: nn.Conv2d, extra: int) -> nn.Conv2d:
    new = nn.Conv2d(conv.in_channels + extra, conv.out_channels,
                    conv.kernel_size, conv.stride, conv.padding)
    with torch.no_grad():
        new.weight.zero_()                     # new channels start silent
        new.weight[:, :conv.in_channels] = conv.weight
        new.bias.copy_(conv.bias)
    return new

def coord_channels(box, full_w, full_h, h, w):
    x0, y0, x1, y1 = box                       # tile position in the full image, px
    xs = torch.linspace(x0, x1, w) / full_w * 2 - 1
    ys = torch.linspace(y0, y1, h) / full_h * 2 - 1
    gy, gx = torch.meshgrid(ys, xs, indexing="ij")
    return torch.stack([gx, gy])               # (2, h, w), values in [-1, 1]
Errores que parecían resultados
Añadido en septiembre de 2026 a partir del registro del proyecto de esa semana. Dos errores y un casi-fallo me enseñaron más que las ejecuciones.
- Coordenadas que no hacían nada. La función pensada para añadir canales de coordenadas devolvía la imagen sin cambios y nunca se llamaba, aunque su docstring prometía la concatenación en la primera convolución. Una ablación explícita dio una diferencia de exactamente 0,0. La corrección para la ruta sin entrenamiento, un tinte de color que depende de la posición, era entonces demasiado débil: ±1 % son unos 2,5 niveles de 255, por debajo del ruido de JPEG. Subió al 5 %, unos 13 niveles.
- Un casi-fallo: un adaptador apagado por el backend de atención. La revisión de código del pipeline combinado encontró xformers activado después de
load_ip_adapter(). Si xformers hace fallback, sustituye los procesadores de atención de IP-Adapter por otros planos, sin ningún error, y el adaptador simplemente deja de tener efecto. El revisor lo valoró como probable (85 %); nada en una ejecución mostró que hubiera pasado. El orden ahora es teselado del VAE, xformers y después el adaptador, con una comprobación de la clase del procesador después. - Una sonda que pasó por accidente. La primera sonda de AnimateDiff leía la dimensión principal de tensores 4D como el eje de fotogramas. La guía sin clasificador duplica esa dimensión, el recuento salía el doble del número de tiles, y la sonda decía OK. Ahora solo lee tensores 5D, donde el eje de fotogramas es real.
La lección es ahora una regla del proyecto: sin fallbacks silenciosos, y cada sonda tiene un modo de control que rompe deliberadamente el mecanismo y tiene que devolver FAIL. Una sonda que nunca se ha visto fallar no demuestra nada. Añadir a posteriori un modo de control a cada una de las once técnicas de verificación del proyecto sigue pendiente. Cómo escribo reglas así para los agentes está en el post sobre mi CLAUDE.md.
Idea adicional: menos tiles en lugar de tiles más inteligentes
Una hipótesis sin ejecuciones detrás. Detail Daemon (y su port a ComfyUI) reconfigura el calendario de sigma para que los pasos tardíos, de bajo ruido, añadan más detalle, sin reentrenar.
La primera mitad de los pasos de eliminación de ruido maneja las bajas frecuencias: distribución de color, composición, formas grandes. Eso podría ejecutarse sobre una versión reducida en un solo pase, sin tiles y sin costuras de bajas frecuencias. La segunda mitad añade detalle, y Detail Daemon lo hace a través del calendario en lugar de una re-eliminación recursiva. Si esto se sostiene, la mitad de los pasos es barata y sin costuras, y el teselado sobrevive solo en la fase de detalle, probablemente todavía necesario por encima de unos 2048 de lado, ya que los mapas de atención a 4096×4096 tampoco caben en 80 GB. El experimento de ahorro de pasos (cinco métodos con cinco presupuestos de pasos, detalle medido con varianza del Laplaciano, energía de alta frecuencia y pendiente espectral) está escrito y no ejecutado. Los nodos de teselado y frecuencia que sí uso en grafos de producción están en el post sobre nodos personalizados de ComfyUI y en /comfyui/.
Lo que nada de esto demuestra
- La ablación completa no está hecha. La ejecución con SANA que informé en abril no es un entrenamiento completo ni una comparación contra líneas base, y su registro no está en el repositorio. El PSNR de la costura, la razón ΔE entre bordes de tile e interiores y el HF-SSIM en máscaras de piel y pelo no están medidos.
- No sé qué arquitectura gana. La atención lineal por bloques sobre SANA debería ganar en memoria, un Klein con caché en calidad, y la atención al estilo SVD es el port más directo. Cuál gana en un ablation real no lo voy a adivinar.
- No sé cómo escala. Todas las sondas se ejecutaron sobre cuadrículas de 3×3 a 7×7; una cuadrícula de 100 tiles necesita compresión al estilo FramePack o una ventana deslizante.
- El nivel semántico no está probado, y la idea de Detail Daemon es un esbozo.
Actualización, septiembre de 2026. Nada de esto ha cambiado. Los últimos commits de experimentos en el proyecto son del 26 de abril. En mayo corregí un fallo latente en una sonda antes de que pudiera costar tiempo de GPU, y preparé el proyecto para ejecuciones largas: una lista de funciones, un registro de problemas y una compuerta de sintaxis que debe pasar antes de alquilar cualquier GPU. Al revisar esta actualización, encontré ese trabajo todavía sin confirmar en disco, lo que rompe mi propia regla de que git es la fuente de verdad. El siguiente paso es el mismo que en abril: una sesión de GPU que vuelva a ejecutar cada hipótesis fijada con su sonda, y después la ablación. La segunda parte de esta serie no se ha publicado, y el repositorio de código sigue privado. Lee todo lo anterior como hipótesis con unas pocas señales tempranas.
Qué haría de otra manera
- Controles negativos desde el primer día. Los dos errores de arriba son del tipo que una ejecución de control detecta de inmediato.
- Mirar las tiras antes de entrenar con ellas. Los saltos de contenido se notaron después de que ya se hubieran ejecutado los dos primeros ajustes finos.
- Un cambio por comparación. La primera ejecución del método de vista previa global y la de la línea base diferían en muestreador, intensidad, semilla, tamaño de imagen y prompt negativo a la vez, así que no decía nada sobre la vista previa. La solución fue alinear todos ellos y añadir una ejecución con la vista previa desactivada.
El original en ruso se publicó en Habr.