Por que a difusão desenha costuras em fotos de 40 megapixels, e como dar memória aos tiles
Autora: Anastasiia Butova, engenheira de ComfyUI e modelos de difusão, Belgrado · publicado em 2026-04-26 · atualizado em 2026-09-23
Tradução da versão em inglês: English
Um arquivo profissional de retoque tem de 40 a 150 megapixels, e um modelo de difusão trabalha com um a quatro de cada vez, então todo pipeline corta a foto em tiles. Isso traz dois problemas: um degrau visível nas bordas dos tiles e um modelo que não tem ideia do que está olhando. Este post cobre por que a mistura não consegue remover o degrau, quais mecanismos de memória da difusão de vídeo se transferem de quadros para tiles, por que cada tile deveria receber a imagem inteira e suas próprias coordenadas, e o que mostraram minhas primeiras rodadas, com as falhas. Trabalhei como retocadora por mais de vinte anos e estou no quarto ano de fazer a difusão se comportar em arquivos como esses; o trabalho faz parte da pesquisa de img2img em alta resolução por trás do Happyin.ai. Revisado em setembro de 2026: correções e resultados posteriores têm essa data.
Por que todo mundo faz tiling
Retoque não acontece em 2048 pixels de lado. Uma Phase One IQ4 dá 14200×10600, uma Hasselblad H6D-100c dá 11600×8700, uma Canon R5 dá 8192×5464, e tudo isso ainda precisa de trabalho em pele, cabelo, cor, luz e fundo. Os modelos atuais são nativos em 1024 a 2048: SDXL e SANA em 1024 (o SANA foi treinado além, até 4K), FLUX e Klein de forma aceitável em 2048. Abaixo de 1024, a qualidade cai e o número de tiles cresce.
Com tile de 1024 e uma sobreposição pequena, um arquivo de 60 MP tem 75 a 80 tiles, 100 MP cerca de 130, 150 MP cerca de 190. A sobreposição é o que esconde as costuras, e ela multiplica a contagem: o mesmo arquivo de 150 MP tem cerca de 270 tiles com 25% de sobreposição e cerca de 540 com 50%. Então 150 tiles ou mais por imagem é um caso de trabalho normal, e qualquer mecanismo cujo custo cresce com o quadrado do número de tiles está descartado antes de começar. Ele não cabe em 80 GB de VRAM, e também não cabe em 192 GB.
Por que a mistura não consegue eliminar as costuras
Sobreposição mais mistura é a correção usual, e a mistura se comporta de forma diferente em frequências diferentes. Em conteúdo suave (um gradiente de céu, um tom de pele, uma queda suave num reflexo de metal) uma transição cruzada esconde bem um degrau de cor. Em cabelo, pedra, grão ou arranhões finos ela falha de uma de duas formas: um degrau duro continua na borda, ou a textura é borrada, porque dentro da sobreposição você faz a média de duas texturas que o modelo desenhou de forma independente.
O borrão tem um número simples por trás. Duas texturas não correlacionadas de contraste igual, calculadas em média 50/50, mantêm √0,5 do seu contraste, cerca de 71%. Na ilustração sintética abaixo, medi 0,70 no meio da sobreposição.
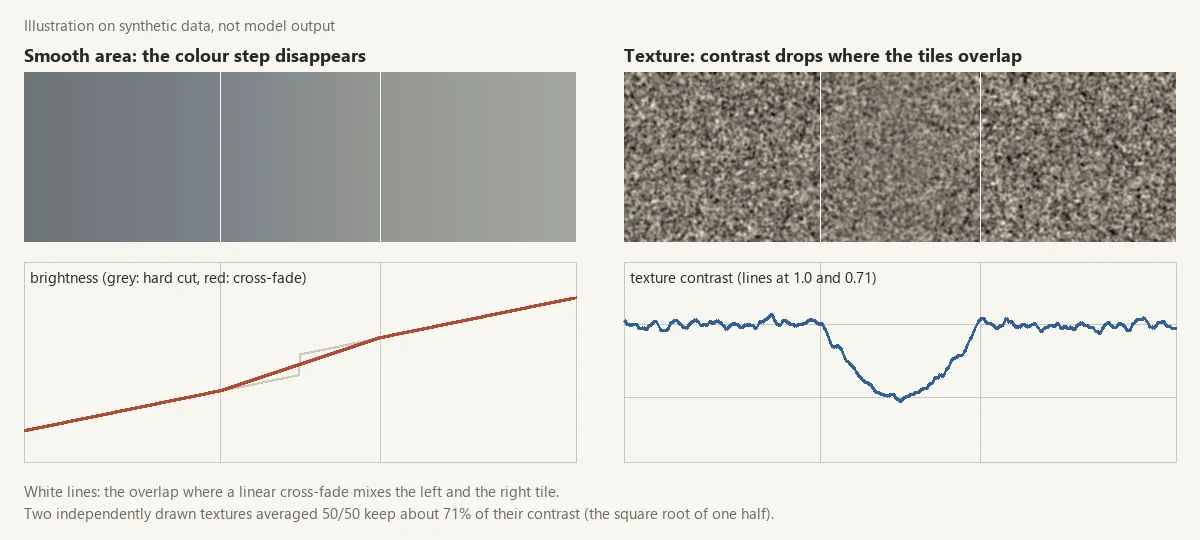
Um único botão não consegue consertar os dois: quanto mais você mistura, mais suave fica a costura de cor, e mais plana fica a textura ao longo de cada borda de tile. E o próprio degrau de cor vem de tiles que derivam de forma independente. Nada diz ao tile (3, 5) qual cor o tile (3, 4) escolheu.
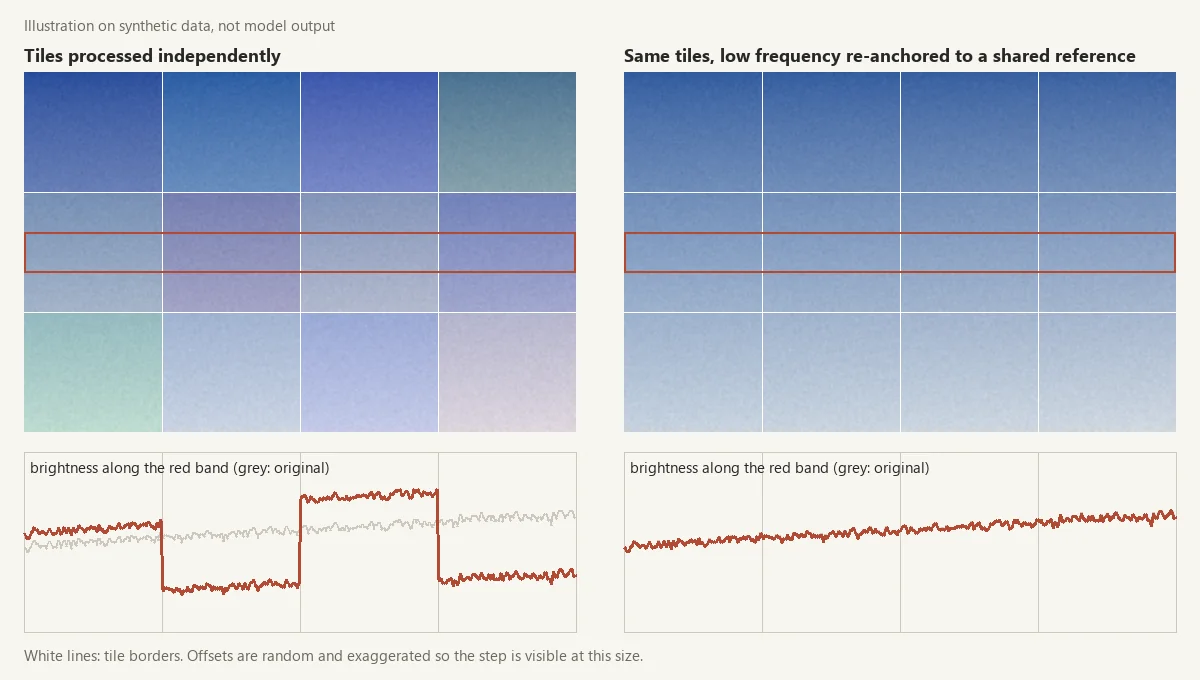
Neste brinquedo, o maior degrau numa borda de tile cai de 18,5 níveis de 255 para 0,5. Os deslocamentos estão exagerados, mas o princípio é a direção de todo este post: dê a cada tile uma referência que ele compartilha com os vizinhos, e corrija as baixas frequências contra essa referência, e não umas contra as outras. O ResMaster faz uma versão disso para geração, alinhando as componentes de baixa frequência de cada patch com uma referência de baixa resolução a cada passo de remoção de ruído.
O que um mecanismo de memória para tiles precisa fazer
- Um custo que não cresce quadraticamente com o número de tiles. A atenção 3D completa está descartada.
- Algum uso sem retreinamento. Mesmo um uso parcial, só na inferência, é uma grande vantagem.
- Saída contínua e precisa ao pixel. Nós retocamos textura, não geramos uma estética. Modelos de tokens discretos, como o Cosmos, com seu vocabulário FSQ de 64K, eliminam detalhes finos na quantização.
- Uma primitiva que eu consiga extrair. O Wan 2.1 (14B) e o HunyuanVideo (13B) carregam vídeo longo, controle de movimento, sincronização de áudio e composição multi-plano; metade disso resolve problemas que uma foto não tem, e eu pagaria por tudo em VRAM. O SANA-Video, o AnimateDiff, o SVD e o FramePack isolam cada um a sua primitiva de memória. E Apache 2.0 sempre que possível, para que o resultado possa entrar num produto sem negociação.
O eixo principal em que escolho é como um mecanismo esquece tiles terminados, para que 200 deles não fiquem na VRAM com todos os seus tensores K/V. Uma janela deslizante guarda os últimos poucos e é cega ao que está longe. A compressão geométrica mantém os vizinhos em resolução total e os tiles distantes comprimidos, de modo que o total converge. O estado acumulado não guarda tile algum, só duas pequenas somas corridas.
Ideia um: modelos de vídeo lembram quadros, modelos de foto não
Por "modelo de foto" quero dizer um modelo de difusão comum de imagem para imagem: SDXL, FLUX, Klein, SANA. Quando um modelo de vídeo gera o quadro 18, ele também vê o 17, o 16, alguns quadros-chave iniciais, às vezes o primeiro. Essa memória vive na arquitetura (atenção sobre o eixo do tempo, um estado acumulado, um cache KV entre blocos), e é por isso que os fundos não tremem e a cor não deriva entre quadros.
Um modelo de foto que processa o tile (3, 5) recebe seus pixels e um prompt de texto. Nenhum vizinho à esquerda, nenhum acima, nenhuma ideia de que aquilo é uma só imagem. Mover a memória do eixo do tempo para a grade espacial endereça as costuras (os tiles lembram a cor dos vizinhos) e parte da semântica (o tile do cabelo sabe que abaixo dele começa um pescoço, e não pelo). A literatura de vídeo tem oito classes arquiteturais de memória, e nem todas sobrevivem à passagem para um plano:
| tipo | mecanismo | exemplos | para tiles |
|---|---|---|---|
| A · atenção 3D completa | cada token vê todos os tokens | Wan | descartar: quadrática, não roda com 64+ tiles |
| B · atenção linear por blocos | somas corridas S = Σ φ(K)ᵀV, Z = Σ φ(K)ᵀ | SANA-Video | principal: estado constante |
| C · janela deslizante | atende aos últimos W quadros | CausVid | reserva: bom localmente, cego a tiles distantes |
| D · espaço e tempo fatorados | camadas temporais depois de cada camada espacial | SVD, AnimateDiff | mapeamento direto: "em todos os quadros" vira "em todos os tiles" |
| E · quadro âncora | cada quadro atende a um quadro âncora | Rolling Forcing, StreamingT2V | complemento: um tile âncora alinha a cor |
| F · compressão geométrica | quadros próximos inteiros, os distantes comprimidos | FramePack | principal: vizinhos inteiros, diagonais 2×, distantes 4× |
| G · compartilhamento de cache | features calculadas uma vez e reutilizadas entre passos | Ca2-VDM | complemento: calcular as features dos vizinhos uma vez |
| H · tokens discretos | vocabulário FSQ, previsão do próximo token | Cosmos | descartar: incompatível com edição contínua de pixels |
Três deles importam.
B, atenção linear por blocos, do SANA-Video. Cada bloco (um quadro ali, um tile aqui) soma suas chaves e valores em dois acumuladores, e o bloco seguinte lê dos acumuladores em vez de ler de cada token anterior. O estado não cresce com o número de blocos, então cem tiles custam o que dez custam. O SANA já usa atenção linear em todas as camadas, então a primitiva já está lá sem custo extra.
Atualização, setembro de 2026. A versão de abril colocava esse estado em cerca de 380 MB para o SANA 1.6B, usando uma largura de 2.304 e 28 camadas. Os dois números estavam errados para esse modelo: 2.304 é a largura dos embeddings do codificador de texto (
caption_channels), e 28 camadas pertencem ao modelo de 0,6B. O SANA 1.6B tem 20 camadas com 70 cabeças de 32 dimensões cada (config), e sua atenção linear guarda S e Z por cabeça, em fp32 (SanaLinearAttnProcessor2_0no diffusers). São 33×32 números por cabeça, cerca de 6 MB para as 20 camadas. Mesmo uma contagem grosseira, uma matriz de 2.240×2.240 por camada em fp16, dá cerca de 200 MB. A conclusão fica mais forte: o estado é constante em relação ao número de tiles, e pequeno.
D, espaço e tempo fatorados, como no SVD. O SVD insere camadas de convolução e atenção temporal depois de cada camada espacial de uma UNet do SD 2.1: 656M de parâmetros novos sobre 1.521M, então a parte de vídeo é 43% do modelo. (O original em russo dizia SDXL; o artigo do SVD diz SD 2.1. Corrigido em setembro de 2026.) Mecanicamente é um reshape: depois de um bloco espacial, (B·T, C, H, W) vira (B·H·W, T, C), passa pela atenção temporal e volta. Coloque o número de tiles no lugar de T, e "como este pixel fica em cada quadro" vira "como esta posição fica em cada tile". É a adaptação (port) mais literal (likewise for 'outras duas portagens', 'portagem mais direta'), e eu esperava que fosse a mais frágil. Os módulos de movimento do AnimateDiff são a mesma ideia, já treinados e utilizáveis na inferência, mas limitados a 32 quadros, portanto 32 tiles.
F, compressão geométrica do FramePack (Lvmin Zhang, o autor do ControlNet). Quadros próximos entram no contexto com densidade total, quadros distantes mais comprimidos, de modo que o total converge para um limite fixo. Para tiles: (3, 5) vê (2, 5), (3, 4), (3, 6) e (4, 5) com densidade total, as diagonais com compressão 2×, os tiles distantes com 4×. O contexto fica o mesmo qualquer que seja o tamanho da foto, então grades 16×16 funcionam sem a explosão quadrática.
Os trabalhos mais próximos vão em direções vizinhas. O PatchVSR adapta um modelo de vídeo para super-resolução por patches, mas sua atenção temporal fica dentro de um patch, entre os quadros daquele patch. A Sliding Tile Attention acelera a atenção em DiTs de vídeo entre 2,8 e 17× em relação ao FlashAttention-2; a ideia de tile deslizante veio dali, mas é um resultado de velocidade. (O texto de abril chamava esse intervalo de ponta a ponta; no artigo ele vale para a atenção. Corrigido em setembro de 2026.) O FrescoDiffusion (março de 2026) é o primo mais próximo: remoção de ruído em tiles para image-to-video em 4K, com cada tile fundido a uma referência de baixa resolução a cada passo de tempo. Ele gera vídeo em vez de editar uma foto. Não encontrei um experimento sistemático que use a atenção temporal de vídeo como atenção entre tiles para uma imagem parada, em várias arquiteturas.
Um dataset de vizinhos, não de tiles
Quase ninguém escreve sobre o dataset, e ele é metade da tarefa. Para aprender a lembrar dos vizinhos, o modelo precisa ver sequências de vizinhos. Uso faixas: uma linha ou coluna reta atravessando a foto, cortada em tiles.
A fonte é um conjunto de fotos de joias que eu tinha à mão, cerca de 52.500 fotos. Joia concentra tudo em que o tiling ingênuo falha: bordas finas, refração, metal reflexivo com sombras irregulares, pedras com textura fina. Cada foto é cortada em três escalas (512, 768, 1024), com três sobreposições (0%, 25%, 50%), em quatro direções. Só são guardadas as faixas da esquerda para a direita e de cima para baixo; as inversas vêm de np.flip no loader. A inversão importa para a atenção linear por blocos, porque ela é causal: um tile vê apenas o resumo corrido dos tiles anteriores, e treinado só da esquerda para a direita, nunca viu nenhum outro percurso.
No papel, são cerca de 70 faixas por foto e de 3 a 4 milhões de exemplos para o conjunto inteiro. O pipeline foi desenhado para parar em 400.000 faixas guardadas, com os tiles redimensionados para 256×256 na primeira rodada e os originais mantidos para um novo corte depois. Verificado em setembro de 2026: segundo o manifesto, a única execução até agora cortou 7.368 faixas de 100 fotos, 74 por foto, perto da estimativa.
Montar isso deu a observação mais útil da semana: as faixas atravessam fronteiras de objetos. Numa foto de 5184×3456, a linha 4 na escala 512 vai pele, pele, pele, ponta de dedo, contas de pulseira. Em 24 a 60 quadros por segundo, quadros de vídeo consecutivos ficam a 17 a 42 ms de distância, com pouco movimento e um fluxo óptico suave; tiles vizinhos pulam da pele para o metal num único passo. Um passo de meio tile faz uma faixa se comportar como um pan lento, e o conjunto final mistura as três sobreposições, de saltos duros a pans suaves.
O que rodei em abril
Na época do post original, só o SANA. Ele foi treinado em 512, depois 1024, 2K e 4K, então um tile de 1024 é nativo, e a atenção linear já faz parte do backbone. Rodei um treinamento pequeno em faixas de teste com tile 1024 e duas perguntas: a perda converge, e o mecanismo se transfere do eixo do tempo para o plano espacial? A perda convergiu, e o modelo aprendeu a conciliar tiles vizinhos da forma como antes conciliava quadros vizinhos. Não publiquei números de uma rodada de teste e continuo sem publicá-los.
Atualização, setembro de 2026. Relendo o repositório do projeto, não encontrei nenhum log daquele treinamento do SANA; as curvas de perda que ele guarda pertencem a outras duas portagens. Então trate a frase sobre o SANA acima como o meu relato de abril, e não como evidência. O que as notas daquela semana contêm: na inferência, ligar o estado acumulado do SANA mudou a saída em média 19,5 níveis de 255, quando a checagem de sanidade para abaixo de 0,5. O mecanismo não é um no-op silencioso, o que é bem menos do que "melhor". As outras duas portagens foram ajustadas em sequências de tiles de um conjunto separado de cerca de 7.000 fotos de 1024 px ou maiores. SDXL com atenção no estilo SVD entre tiles: a média móvel de 100 passos da perda caiu cerca de 40%, e as previsões tinham uma estrutura reconhecível, mas um moiré diagonal alinhado à grade de tiles, que atribuo ao modo como minha implementação faz média por pooling das chaves e valores entre tiles. Módulos de movimento do AnimateDiff sobre SD 1.5: os pesos mudaram (norma de Frobenius da atualização 15,28), mas as saídas antes e depois do ajuste pareciam quase idênticas. As notas discordam entre si sobre o quanto aquela perda caiu, então deixo o número de fora. Li as saídas idênticas como um resultado negativo para módulos de movimento em tiles, e minha explicação de trabalho são os saltos de conteúdo descritos acima: os módulos carregam um prior de movimento suave que fotos não satisfazem. Ambos eram snapshots subtreinados, então os números são um limite inferior, não um resultado.
Ideia dois: dar a cada tile a imagem inteira e sua posição
Se você corta uma foto de 6000×4000 em tiles, está segurando a imagem inteira, e não usá-la é estranho. Reduza-a no espaço latente e alimente-a, junto com cada tile, como canais extras na primeira convolução. Acrescente a posição do tile como mais dois canais, (x, y) ∈ [−1, 1], para que o tile (3, 5) saiba que é o (3, 5) e não algum ponto de 512 pixels no vazio. O PatchVSR faz as duas coisas para super-resolução de vídeo: um ramo global vê o vídeo inteiro redimensionado, e a localização do patch é injetada no modelo.
O que a posição vale: PaDIS
O PaDIS (Hu et al., NeurIPS 2024) treina um prior de difusão só com patches e concatena dois arrays posicionais a cada patch: as coordenadas x e y de cada pixel na imagem completa, escaladas para [−1, 1], sem ruído adicionado a elas. A ablação no apêndice deles (Tabela 6, reconstrução de CT) é direta: 33,57 dB de PSNR com posição, 23,25 dB sem, e 24,51 dB sem posição mesmo quando inicializado a partir de uma reconstrução de base. Os autores escrevem que a rede "completely failed to learn the patch-based prior". Dez decibéis é a diferença entre funcionar e não funcionar.
Duas ressalvas antes de tomar emprestado esse número. É TC, não fotografias (and 'reconstrução de TC' in the previous paragraph instead of 'reconstrução de CT') (and 'reconstrução de TC' in the previous paragraph instead of 'reconstrução de CT'), e um modelo no espaço de pixels treinado do zero com patches. Ninguém mediu o que as coordenadas acrescentam a um modelo latente pré-treinado em retoque de 40 MP; esse experimento é o primeiro da minha lista e ainda não foi feito.
Por que isso importa é fácil de ver. Sem posição, uma só função precisa restaurar cada patch sem nenhum jeito de ligar o conhecimento a um lugar ("rostos costumam estar aqui, gradiente de céu ali"), então ela faz média, e a média parece ruído. Dois números por pixel custam quase nada, e quase nenhum pipeline de tiles os alimenta, provavelmente porque um modelo pré-treinado tem uma largura de entrada fixa e cada canal extra exige treinamento.
Três níveis do que um tile deveria saber
| nível | significado | quem faz |
|---|---|---|
| geométrico | "sou o tile (3, 5) de uma grade 8×8" | canais de coordenadas do PaDIS |
| visual | "a imagem inteira tem esta cara" | DemoFusion, FreeScale, DC-VSR, ResMaster |
| semântico | "isto é pele, ao lado tem cabelo, não invente uma orelha" | AccDiffusion v2, uma legenda de VLM por tile |
O VAE em tiles de fábrica dá o nível zero: pixels e um prompt global.
Para o nível visual, duas coisas funcionam: um latente de VAE reduzido da imagem inteira alimentando a primeira convolução (preserva estrutura espacial, cor, iluminação), ou um vetor de 64 dimensões com estatísticas globais (cor média, exposição, balanço de brancos) modulando o AdaLN-Zero em cada bloco, que é mais barato mas não carrega informação espacial. Um embedding de imagem CLIP passado pelo IP-Adapter não funciona bem: um vetor sem eixos espaciais não consegue dizer "a borda de cima deste tile é céu azul escuro, a de baixo é um tom pálido".
Medi isso em vez de presumir. Uma sonda contrafactual no SDXL (and 'O registro da sonda'), prévia real contra uma prévia de ruído aleatório com escala de adaptador 0,4, deu uma diferença média de 0,0066 por pixel (máximo 0,26), abaixo do limiar de 0,02 abaixo do qual considero um sinal decorativo. O codificador de imagem dispara em toda chamada, o adaptador roda e quase não muda nada. Meu palpite em abril foi uma incompatibilidade de codificador: o adaptador foi treinado com embeddings de imagem do ViT bigG, enquanto a configuração usava o par padrão do SDXL, CLIP-L e CLIP-G.
Atualização, setembro de 2026. Esse palpite ainda não foi testado. O registro do teste mostra um segundo candidato: a imagem inteira chega ao adaptador como 224×224 pixels, o que por si só limita o que ele consegue carregar.
Para o nível semântico, o caminho direto é uma legenda por tile de um VLM como o Florence-2, cerca de 50 ms por tile: um tile com ombro e cabelo recebe "pele e cabelo, sem pelo", e uma textura de pelo alucinada contradiz o próprio prompt. A variante mais barata que quero testar é uma descrição única da imagem inteira, com o peso de tokens ausentes reduzido em cada tile, de modo que o tile do céu silencie rosto, cabelo e metal. O AccDiffusion v2 constrói prompts por patch a partir de um prompt de imagem, em espírito parecido. Não testado do meu lado.
Juntando tudo, a entrada de um tile é o seu próprio latente, dois canais de coordenadas, o latente reduzido da imagem inteira e, opcionalmente, uma máscara de segmentação. Os novos pesos de entrada precisam começar em zero. Caso contrário, no passo zero o modelo vê sua entrada normal mais pesos aleatórios, e o comportamento pré-treinado quebra já no primeiro passe. Com inicialização zero, ele começa idêntico ao backbone e aprende a usar os canais novos gradualmente, o mesmo truque das convoluções zero do ControlNet.
# Illustration, not production code: widen a pretrained first convolution
# so each tile can also receive its coordinates and a global preview.
import torch
import torch.nn as nn

def widen_first_conv(conv: nn.Conv2d, extra: int) -> nn.Conv2d:
    new = nn.Conv2d(conv.in_channels + extra, conv.out_channels,
                    conv.kernel_size, conv.stride, conv.padding)
    with torch.no_grad():
        new.weight.zero_()                     # new channels start silent
        new.weight[:, :conv.in_channels] = conv.weight
        new.bias.copy_(conv.bias)
    return new

def coord_channels(box, full_w, full_h, h, w):
    x0, y0, x1, y1 = box                       # tile position in the full image, px
    xs = torch.linspace(x0, x1, w) / full_w * 2 - 1
    ys = torch.linspace(y0, y1, h) / full_h * 2 - 1
    gy, gx = torch.meshgrid(ys, xs, indexing="ij")
    return torch.stack([gx, gy])               # (2, h, w), values in [-1, 1]
Bugs que pareciam resultados
Acrescentado em setembro de 2026 a partir do log do projeto daquela semana. Dois bugs e um quase-acidente ensinaram mais do que as rodadas.
- Coordenadas que não faziam nada. A função que deveria acrescentar os canais de coordenadas devolvia a imagem sem mudança e nunca era chamada, enquanto sua docstring prometia a concatenação na primeira convolução. Uma ablação explícita mostrou uma diferença de exatamente 0,0. A correção para o caminho sem treinamento, um tingimento de cor dependente da posição, ficou fraca demais: ±1% equivale a cerca de 2,5 níveis de 255, abaixo do ruído de JPEG. Subiu para 5%, cerca de 13 níveis.
- Quase-acidente: um adaptador desligado pelo backend de atenção. A revisão de código do pipeline combinado encontrou o xformers ativado depois de
load_ip_adapter(). Se o xformers faz fallback, ele substitui os processadores de atenção do IP-Adapter por processadores comuns, sem erro, e o adaptador simplesmente deixa de ter qualquer efeito. O revisor deu 85% de chance de ter acontecido; nada numa execução mostrou que aconteceu. A ordem agora é VAE tiling, xformers, depois o adaptador, com uma checagem da classe do processador depois. - Uma sonda que passou por acaso. A primeira sonda do AnimateDiff lia a dimensão inicial de tensores 4-D como o eixo dos quadros. O classifier-free guidance (CFG) dobra essa dimensão, a contagem saiu como o dobro do número de tiles, e a sonda disse OK. Agora ela lê apenas tensores 5-D, em que o eixo dos quadros é real.
A lição virou regra do projeto: nada de fallbacks silenciosos, e toda sonda ganha um modo de controle que quebra o mecanismo de propósito e precisa retornar FAIL. Uma sonda que nunca foi vista falhando não prova nada. Acrescentar um modo de controle a cada uma das onze técnicas de verificação do projeto ainda está em aberto. Como escrevo regras assim para agentes está no post sobre meu CLAUDE.md.
Ideia bônus: menos tiles em vez de tiles mais inteligentes
Uma hipótese sem rodadas por trás. O Detail Daemon (e seu port para ComfyUI) remodela o cronograma de sigma para que os passos finais, de ruído baixo, acrescentem mais detalhe, sem retreinamento.
A primeira metade dos passos de remoção de ruído cuida das baixas frequências: distribuição de cor, composição, formas grandes. Isso poderia rodar numa versão reduzida em uma única passagem, sem tiles e sem costuras de baixa frequência. A segunda metade acrescenta detalhe, e o Detail Daemon faz isso pelo cronograma, e não por uma remoção de ruído recursiva. Se isso se sustentar, metade dos passos fica barata e sem costuras, e o tiling sobrevive só na fase de detalhe, provavelmente ainda necessário acima de cerca de 2048 de lado, já que mapas de atenção em 4096×4096 também não cabem em 80 GB. O experimento de economia de passos (cinco métodos em cinco orçamentos de passos, detalhe medido por variância do Laplaciano, energia de alta frequência e inclinação espectral) está escrito e não foi rodado. Os nós de tiling e frequência que uso de fato em grafos de produção estão no post sobre nós customizados do ComfyUI e em /comfyui/.
O que nada disso prova
- A ablação completa não foi feita. A rodada do SANA que relatei em abril não é um treinamento completo nem uma comparação com baselines, e o log não está no repositório. PSNR na costura, a razão ΔE entre bordas de tile e interiores, e HF-SSIM em máscaras de pele e cabelo não foram medidos.
- Não sei qual arquitetura vence. A atenção linear por blocos do SANA deveria vencer em memória, um Klein com cache deveria vencer em qualidade, e a atenção no estilo SVD é a portagem mais direta. Qual vence numa ablação real não vou chutar.
- Não sei como isso escala. Todas as sondas rodaram em grades de 3×3 a 7×7; uma grade de 100 tiles precisa de compressão no estilo FramePack ou de uma janela deslizante.
- O nível semântico não foi testado, e a ideia do Detail Daemon é um esboço.
Atualização, setembro de 2026. Nada disso mudou. Os últimos commits de experimentos no projeto são de 26 de abril. Em maio, corrigi um crash latente numa sonda antes que ele custasse tempo de GPU, e preparei o projeto para execuções longas: uma lista de funcionalidades, um log de problemas e um portão de sintaxe que precisa passar antes de qualquer GPU ser alugada. Ao verificar para esta atualização, encontrei esse trabalho ainda sem commit no disco, o que quebra minha própria regra de que o git é a fonte da verdade. O próximo passo é o mesmo de abril: uma sessão de GPU que roda de novo cada hipótese corrigida com a sua sonda, e depois a ablação. A segunda parte desta série não foi publicada, e o repositório de código continua privado. Leia tudo acima como hipóteses com alguns primeiros sinais.
O que eu faria diferente
- Controles negativos desde o primeiro dia. Os dois bugs acima são do tipo que uma rodada de controle pega de imediato.
- Olhar as faixas antes de treinar com elas. Os saltos de conteúdo foram notados depois que os dois primeiros ajustes já tinham rodado.
- Uma mudança por comparação. A primeira rodada do método de prévia global contra a baseline diferia em sampler, força, semente, tamanho da imagem e prompt negativo ao mesmo tempo, então não disse nada sobre a prévia. A correção foi alinhar todos eles e acrescentar uma rodada com a prévia desligada.
O original em russo foi publicado no Habr.