Почему диффузия рисует швы на 40-мегапиксельных фото и как дать тайлам память
Автор: Anastasiia Butova, инженер по ComfyUI и диффузионным моделям, Белград · опубликовано 2026-04-26 · обновлено 2026-09-23
Перевод английской версии: English
Профессиональный файл для ретуши имеет от 40 до 150 мегапикселей, а диффузионная модель работает с одним-четырьмя за раз, поэтому любой конвейер нарезает фото на тайлы. Отсюда две проблемы: видимый перепад на границах тайлов и модель, которая понятия не имеет, что перед ней. В этом посте: почему смешивание не может убрать перепад, какие механизмы памяти из видеодиффузии переносятся с кадров на тайлы, почему каждый тайл должен получать всю картину и свои координаты и что показали мои первые прогоны, включая неудачи. Я работала ретушёром больше двадцати лет и на четвёртом году делаю так, чтобы диффузия вела себя на таких файлах нормально; эта работа относится к исследованию img2img высокого разрешения, стоящему за Happyin.ai. Пересмотрено в сентябре 2026 года: исправления и более поздние результаты помечены этой датой.
Почему все режут на тайлы
Ретушь не живёт на 2048 пикселях по стороне. Phase One IQ4 даёт 14200×10600, Hasselblad H6D-100c — 11600×8700, Canon R5 — 8192×5464, и всё это по-прежнему требует работы с кожей, волосами, цветом, светом и фоном. Современные модели нативны для 1024–2048: SDXL и SANA на 1024 (SANA дообучали до 4K), FLUX и Klein приемлемо на 2048. Ниже 1024 качество падает, а число тайлов растёт.
При тайле 1024 с небольшим перекрытием файл на 60 МП — это 75–80 тайлов, на 100 МП — около 130, на 150 МП — около 190. Перекрытие и прячет швы, и умножает число: тот же файл на 150 МП — около 270 тайлов при 25 % перекрытии и около 540 при 50 %. Поэтому 150+ тайлов на изображение — обычный рабочий случай, и любой механизм, стоимость которого растёт как квадрат числа тайлов, отпадает сразу. Он не поместится в 80 ГБ VRAM и не поместится даже в 192 ГБ.
Почему смешивание не может убрать швы
Перекрытие и смешивание — обычное решение, но смешивание ведёт себя по-разному на разных частотах. На гладком содержимом (градиент неба, тон кожи, плавный спад отражения на металле) кроссфейд хорошо прячет цветовой перепад. На волосах, камне, зерне или тонких царапинах он проваливается одним из двух способов: жёсткий перепад остаётся на границе, или текстура размазывается, потому что внутри перекрытия вы усредняете две текстуры, которые модель нарисовала независимо.
За размазыванием стоит простое число. Две некоррелированные текстуры одинакового контраста, усреднённые 50/50, сохраняют √0.5 своего контраста, около 71 %. В синтетической иллюстрации ниже я измерила 0.70 в середине перекрытия.
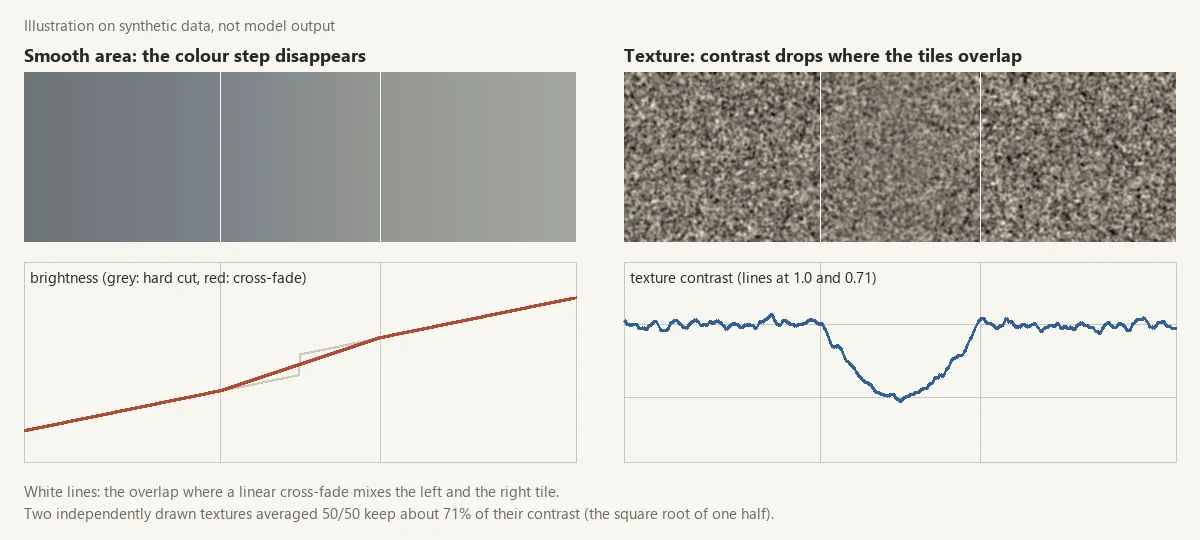
Одной ручкой не исправить оба. Чем сильнее смешивание, тем мягче цветовой шов и тем площе текстура вдоль каждой границы тайла. А сам цветовой перепад возникает потому, что тайлы расходятся независимо. Ничто не говорит тайлу (3, 5), какой цвет выбрал тайл (3, 4).
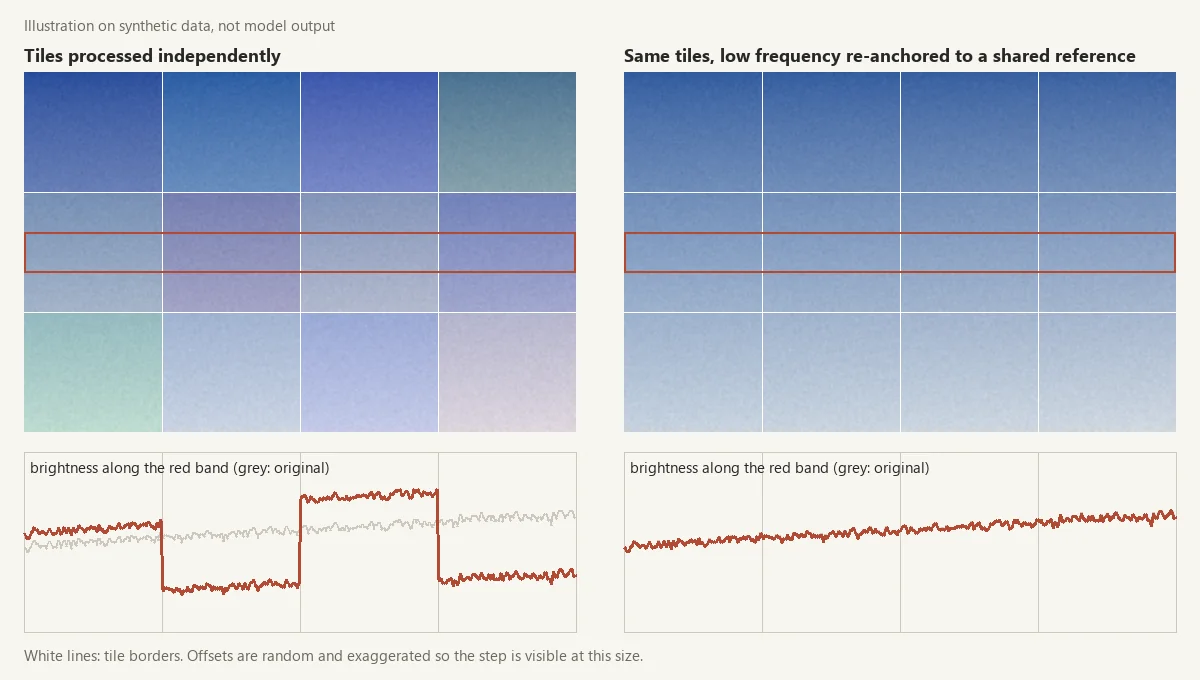
В этой игрушечной модели наибольший перепад на границе тайлов падает с 18.5 уровней из 255 до 0.5. Сдвиги преувеличены, но принцип — направление всего этого поста: дать каждому тайлу опору, которую он разделяет с соседями, и выравнивать низкие частоты по этой опоре, а не друг по другу. ResMaster делает версию этого для генерации: на каждом шаге шумоподавления он выравнивает низкочастотные компоненты каждого патча с низкоразрешённой опорой.
Что должна уметь память для тайлов
- Стоимость, которая не растёт квадратично с числом тайлов. Полное 3D-внимание отпадает.
- Использование без переобучения. Даже частичное использование только при инференсе — большое преимущество.
- Непрерывный выход с точностью до пикселя. Мы ретушируем текстуру, а не генерируем эстетику. Модели с дискретными токенами, например Cosmos с его словарём FSQ на 64 тысячи, теряют мелкие детали при квантовании.
- Примитив, который можно вынуть. Wan 2.1 (14B) и HunyuanVideo (13B) несут длинное видео, управление движением, синхронизацию звука и многокадровую композицию; половина этого решает задачи, которых у фото нет, и я бы платила за всё это VRAM. SANA-Video, AnimateDiff, SVD и FramePack выделяют каждый свой примитив памяти. И лицензия Apache 2.0, где возможно, чтобы результат можно было включить в продукт без переговоров.
Основная ось, по которой я выбираю, — то, как механизм забывает законченные тайлы, чтобы 200 из них не сидели в VRAM со всеми своими тензорами K/V. Скользящее окно хранит последние несколько и слепо к далёкому. Геометрическое сжатие держит соседей в полном разрешении, а далёкие тайлы — сжатыми, так что общий объём сходится. Накопленное состояние не хранит тайлов вообще, только две небольшие накопленные суммы.
Идея первая: видеомодели помнят кадры, фотомодели — нет
Под «фотомоделью» я имею в виду обычную диффузионную модель image-to-image: SDXL, FLUX, Klein, SANA. Когда видеомодель генерирует кадр 18, она также видит 17, 16, некоторые ранние ключевые кадры, иногда первый. Эта память живёт в архитектуре (внимание по оси времени, накопленное состояние, KV-кэш между чанками), и поэтому фоны не дрожат и цвет не уплывает от кадра к кадру.
Фотомодель, обрабатывающая тайл (3, 5), получает свои пиксели и текстовый промпт. Ни соседа слева, ни соседа сверху, никакого понимания, что это одна картина. Перенесите память с оси времени на пространственную сетку — и вы закроете швы (тайлы помнят цвет соседей) и часть семантики (тайл волос знает, что ниже начинается шея, а не мех). В видеолитературе есть восемь архитектурных классов памяти, и не все они переживают переход на плоскость:
| тип | механизм | примеры | для тайлов |
|---|---|---|---|
| A · полное 3D-внимание | каждый токен видит каждый токен | Wan | отбросить: квадратично, не запустится на 64+ тайлах |
| B · блочное линейное внимание | накопленные суммы S = Σ φ(K)ᵀV, Z = Σ φ(K)ᵀ | SANA-Video | основной: постоянное состояние |
| C · скользящее окно | внимание к последним W кадрам | CausVid | запасной: хорошо локально, слеп к далёким тайлам |
| D · разделённые пространство и время | временные слои после каждого пространственного слоя | SVD, AnimateDiff | прямое отображение: «по всем кадрам» становится «по всем тайлам» |
| E · опорный кадр | каждый кадр смотрит на опорный | Rolling Forcing, StreamingT2V | надстройка: опорный тайл выравнивает цвет |
| F · геометрическое сжатие | близкие кадры полные, дальние сжаты | FramePack | основной: соседи полные, диагонали в 2 раза, далёкие в 4 раза |
| G · совместное использование кэша | признаки вычисляются один раз и переиспользуются между шагами | Ca2-VDM | надстройка: признаки соседей вычислить один раз |
| H · дискретные токены | словарь FSQ, предсказание следующего токена | Cosmos | отбросить: несовместимо с непрерывным редактированием пикселей |
Три из них важны.
B, блочное линейное внимание из SANA-Video. Каждый блок (там кадр, здесь тайл) добавляет свои ключи и значения в два аккумулятора, а следующий блок читает из аккумуляторов, а не из каждого предыдущего токена. Состояние не растёт с числом блоков, поэтому сотня тайлов стоит столько же, сколько десять. SANA уже использует линейное внимание в каждом слое, так что примитив есть бесплатно.
Обновление, сентябрь 2026. В апрельской версии это состояние оценивалось примерно в 380 МБ для SANA 1.6B, с шириной 2304 и 28 слоями. Оба числа были неверны для этой модели: 2304 — это ширина эмбеддингов текстового энкодера (
caption_channels), а 28 слоёв относятся к модели 0.6B. У SANA 1.6B 20 слоёв по 70 голов по 32 измерения (конфиг), а её линейное внимание хранит S и Z на каждую голову в fp32 (SanaLinearAttnProcessor2_0в diffusers). Это 33×32 чисел на голову, около 6 МБ на все 20 слоёв. Даже грубый подсчёт, одна матрица 2240×2240 на слой в fp16, даёт около 200 МБ. Вывод стал сильнее: состояние постоянно по числу тайлов и мало.
D, разделённые пространство и время, как в SVD. SVD вставляет слои временной свёртки и временного внимания после каждого пространственного слоя UNet из SD 2.1: 656 миллионов новых параметров из 1521 миллиона, так что видеочасть — 43 % модели. (В русскоязычном оригинале было написано SDXL; статья SVD говорит про SD 2.1. Исправлено в сентябре 2026 года.) Механически это перестановка: после пространственного блока (B·T, C, H, W) становится (B·H·W, T, C), проходит временное внимание и возвращается обратно. Поставьте число тайлов вместо T — и вопрос «как этот пиксель выглядит в каждом кадре» превращается в «как эта позиция выглядит в каждом тайле». Это самый буквальный перенос, и я ожидала, что он будет самым хрупким. Модули движения AnimateDiff — та же идея, уже обученные и пригодные для инференса, но ограниченные 32 кадрами, то есть 32 тайлами.
F, геометрическое сжатие из FramePack (Lvmin Zhang, автор ControlNet). Близкие кадры попадают в контекст в полной плотности, дальние — сжаты сильнее, так что общий объём сходится к фиксированному пределу. Для тайлов: (3, 5) видит (2, 5), (3, 4), (3, 6) и (4, 5) в полной плотности, диагонали — со сжатием 2×, далёкие тайлы — 4×. Контекст одинаков при любом размере фото, поэтому сетки 16×16 работают без квадратичного взрыва.
Ближайшие работы идут в соседних направлениях. PatchVSR адаптирует видеомодель под суперразрешение по патчам, но её временное внимание остаётся внутри патча, между кадрами этого патча. Sliding Tile Attention ускоряет внимание в видео-DiT в 2.8–17 раз относительно FlashAttention-2; идея скользящего тайла пришла оттуда, но это результат о скорости. (В апрельском тексте этот диапазон назван сквозным; в статье он относится к вниманию. Исправлено в сентябре 2026 года.) FrescoDiffusion (март 2026) — ближайший родственник: тайловое шумоподавление для 4K image-to-video, где каждый тайл на каждом таймстепе сливается с низкоразрешённой опорой. Он генерирует видео, а не редактирует фото. Систематического эксперимента, где временное внимание видеомодели используется как межтайловое внимание для неподвижного изображения на разных архитектурах, я не нашла.
Датасет соседей, а не тайлов
Почти никто не пишет о датасете, а это половина задачи. Чтобы научиться помнить соседей, модель должна видеть последовательности соседей. Я использую полосы: одну прямую строку или столбец через фото, нарезанную на тайлы.
Источник — набор ювелирных изделий, который оказался под рукой, около 52 500 фотографий. В ювелирке сосредоточено всё, на чём падает наивный тайлинг: тонкие края, преломление, блестящий металл с неровными тенями, камни с мелкой текстурой. Каждое фото нарезается в трёх масштабах (512, 768, 1024), с тремя перекрытиями (0 %, 25 %, 50 %) в четырёх направлениях. Хранятся только полосы слева направо и сверху вниз; обратные получаются через np.flip в загрузчике. Разворот важен для блочного линейного внимания, потому что оно каузальное: тайл видит только накопленную сводку предыдущих тайлов, и если обучать его только слева направо, он никогда не видел другого обхода.
На бумаге это около 70 полос на фото и 3–4 миллиона примеров на весь набор. Конвейер спроектирован так, чтобы остановиться на 400 000 сохранённых полос, с тайлами, уменьшенными до 256×256 для первого раунда, и оригиналами, сохранёнными для последующей перенарезки. Проверено в сентябре 2026 года: по манифесту, единственный прогон пока нарезал 7368 полос из 100 фото, то есть 74 на фото, близко к оценке.
Сборка дала самое полезное наблюдение недели: полосы пересекают границы объектов. На одном фото 5184×3456 строка 4 на масштабе 512 идёт: кожа, кожа, кожа, кончик пальца, бусины браслета. При 24–60 кадрах в секунду соседние кадры видео отстоят на 17–42 мс, с небольшим движением и плавным оптическим потоком; соседние тайлы перескакивают с кожи на металл за один шаг. Шаг в полтайла делает полосу похожей на медленную панораму, и итоговый набор смешивает все три перекрытия, от жёстких скачков до плавных панорам.
Что я запустила в апреле
На момент исходного поста — только SANA. Её обучали на 512, затем на 1024, 2K и 4K, так что тайл 1024 — нативный, а линейное внимание уже есть в основе. Я провела небольшое обучение на тестовых полосах с тайлом 1024 и задала два вопроса: сходится ли loss и переносится ли механизм с оси времени на пространственную плоскость вообще. Loss сошёлся, и модель научилась согласовывать соседние тайлы так, как раньше согласовывала соседние кадры. Я не публиковала чисел из тестового прогона и до сих пор не публикую.
Обновление, сентябрь 2026. Перечитав репозиторий проекта, я не нашла в нём журнала того обучения SANA; кривые loss, которые там хранятся, относятся к двум другим портам. Поэтому предложение про SANA выше стоит считать моим апрельским отчётом, а не доказательством. Что сохранили заметки прогонов той недели: при инференсе включение накопленного состояния SANA меняло выход в среднем на 19.5 уровня из 255, а проверка на здравый смысл останавливается ниже 0.5. То есть механизм — не тихий no-op, и это гораздо меньше, чем «лучше». Два других порта дообучались на последовательностях тайлов из отдельного набора примерно из 7000 фото размером 1024 px и больше. SDXL с вниманием в стиле SVD между тайлами: скользящее среднее loss за 100 шагов упало примерно на 40 %, предсказания имели узнаваемую структуру, но диагональный муар, выровненный по сетке тайлов, который я отношу к тому, как моя реализация усредняет ключи и значения по тайлам. Модули движения AnimateDiff на SD 1.5: веса изменились (норма Фробениуса обновления 15.28), но выходы до и после дообучения выглядели почти одинаково. Заметки расходятся между собой в том, насколько упал loss, поэтому число я не привожу. Я прочитала одинаковые выходы как негативный результат для модулей движения на тайлах, и моё рабочее объяснение — скачки контента выше: модули несут априорное знание о плавном движении, которому фото не удовлетворяют. Оба были недообученными снимками, так что числа — нижняя граница, а не результат.
Идея вторая: дать каждому тайлу всю картину и позицию
Если вы режете фото 6000×4000 на тайлы, вы держите в руках всю картину, и не использовать её странно. Уменьшите её в латентном пространстве и подайте вместе с каждым тайлом как дополнительные каналы в первую свёртку. Добавьте позицию тайла как два канала, (x, y) ∈ [−1, 1], чтобы тайл (3, 5) знал, что он (3, 5), а не какие-то 512 пикселей в пустоте. PatchVSR делает и то, и другое для суперразрешения видео: глобальная ветка видит уменьшенное полное видео, а позиция патча вводится в модель.
Чего стоит позиция: PaDIS
PaDIS (Hu et al., NeurIPS 2024) обучает диффузионный априор только на патчах и конкатенирует к каждому патчу два массива позиций: координаты x и y каждого пикселя во всём изображении, масштабированные в [−1, 1], без добавления шума. Абляция в их приложении (таблица 6, реконструкция КТ) прямолинейна: 33.57 дБ PSNR с позицией, 23.25 дБ без неё, 24.51 дБ без позиции даже при инициализации от базовой реконструкции. Авторы пишут, что сеть «полностью не смогла выучить априор на основе патчей». Десять децибел — это разрыв между работающим и неработающим.
Прежде чем заимствовать это число, две оговорки. Это КТ, а не фотографии, и модель в пиксельном пространстве обучена с нуля на патчах. Никто не измерил, что добавляют координаты к предобученной латентной модели на ретуши 40 МП; этот эксперимент — первый в моём списке, и он не сделан.
Почему это важно, легко увидеть. Без позиции одна функция должна восстанавливать каждый патч без способа привязать знание к месту («лица обычно здесь, градиент неба там»), поэтому она усредняет, а среднее выглядит как шум. Два числа на пиксель почти ничего не стоят, и почти никакой тайловый конвейер их не подаёт, вероятно потому, что у предобученной модели фиксированная ширина входа, и каждый дополнительный канал означает обучение.
Три уровня того, что должен знать тайл
| уровень | смысл | кто это делает |
|---|---|---|
| геометрический | «я тайл (3, 5) сетки 8×8» | координатные каналы PaDIS |
| визуальный | «вся картина выглядит так» | DemoFusion, FreeScale, DC-VSR, ResMaster |
| семантический | «это кожа, рядом волосы, не придумывай ухо» | AccDiffusion v2, подпись VLM на каждый тайл |
Тайловый VAE из коробки даёт нулевой уровень: пиксели и один глобальный промпт.
Для визуального уровня работают два варианта: уменьшенный VAE-латент всего изображения в первую свёртку (сохраняет пространственную структуру, цвет, освещение) или вектор из 64 глобальных статистик (средний цвет, экспозиция, баланс белого), который модулирует AdaLN-Zero в каждом блоке — дешевле, но без пространственной информации. Эмбеддинг изображения CLIP через IP-Adapter работает плохо: вектор без пространственных осей не скажет «верхний край этого тайла — тёмно-синее небо, а нижний — бледный».
Я это измерила, а не предположила. Контрфактический тест на SDXL: настоящее превью против превью из случайного шума при силе адаптера 0.4, средняя разница 0.0066 на пиксель (максимум 0.26), ниже порога 0.02, ниже которого я считаю сигнал декоративным. Энкодер изображений срабатывает при каждом вызове, адаптер работает, но почти ничего не меняет. В апреле я предполагала несоответствие энкодера: адаптер обучен на эмбеддингах изображений ViT bigG, а в установке использовалась стандартная пара SDXL из CLIP-L и CLIP-G.
Обновление, сентябрь 2026. Это предположение до сих пор не проверено. Запись пробы показывает второго кандидата: всё фото попадает в адаптер как 224×224 пикселя, и это само по себе ограничивает то, что он может передать.
Для семантического уровня прямой путь — подпись на каждый тайл от VLM вроде Florence-2, около 50 мс на тайл: тайл с плечом и волосами получает «кожа и волосы, без меха», и выдуманная текстура меха противоречит собственному промпту. Более дешёвый вариант, который я хочу попробовать, — одно описание на всё изображение с пониженным весом отсутствующих токенов в каждом тайле, так что тайл неба приглушает лицо, волосы и металл. AccDiffusion v2 строит промпты на уровне патчей из одного промпта изображения в похожем духе. Со своей стороны я это не проверяла.
В итоге вход тайла — это его собственный латент, два координатных канала, уменьшенный латент всего изображения и необязательная маска сегментации. Новые веса входа должны начинаться с нуля. Иначе на нулевом шаге модель видит свой обычный вход плюс случайные веса, и предобученное поведение ломается на первом прямом проходе. С инициализацией нулями она начинает идентичной основе и постепенно учится использовать новые каналы — тот же приём, что нулевые свёртки в ControlNet.
# Illustration, not production code: widen a pretrained first convolution
# so each tile can also receive its coordinates and a global preview.
import torch
import torch.nn as nn

def widen_first_conv(conv: nn.Conv2d, extra: int) -> nn.Conv2d:
    new = nn.Conv2d(conv.in_channels + extra, conv.out_channels,
                    conv.kernel_size, conv.stride, conv.padding)
    with torch.no_grad():
        new.weight.zero_()                     # new channels start silent
        new.weight[:, :conv.in_channels] = conv.weight
        new.bias.copy_(conv.bias)
    return new

def coord_channels(box, full_w, full_h, h, w):
    x0, y0, x1, y1 = box                       # tile position in the full image, px
    xs = torch.linspace(x0, x1, w) / full_w * 2 - 1
    ys = torch.linspace(y0, y1, h) / full_h * 2 - 1
    gy, gx = torch.meshgrid(ys, xs, indexing="ij")
    return torch.stack([gx, gy])               # (2, h, w), values in [-1, 1]
Баги, которые выглядели как результаты
Добавлено в сентябре 2026 года по журналу проекта за ту неделю. Два бага и один почти промах научили меня больше, чем прогоны.
- Координаты, которые ничего не делали. Функция, которая должна была добавлять координатные каналы, возвращала изображение без изменений и никогда не вызывалась, хотя её докстринг обещал конкатенацию в первую свёртку. Явная абляция дала разницу ровно 0.0. Исправление для пути без обучения — позиционно-зависимый цветовой оттенок — оказалось слишком слабым: ±1 % — это примерно 2.5 уровня из 255, ниже JPEG-шума. Подняла до 5 %, около 13 уровней.
- Чуть не случившаяся ошибка: адаптер, выключенный бэкендом внимания. (and «два бага и одна чуть не случившаяся ошибка») Ревью кода объединённого конвейера нашло, что xformers включался после
load_ip_adapter(). Если xformers откатывается, он заменяет процессоры внимания IP-Adapter на обычные без всякой ошибки, и адаптер просто перестаёт что-либо делать. Ревьюер оценил вероятность в 85 %; ничто в прогоне не показало, что это произошло. Теперь порядок такой: тайлинг VAE, затем xformers, затем адаптер, с проверкой класса процессора после него. - Проба, которая прошла по случайности. Первая проба AnimateDiff читала ведущую размерность 4-мерных тензоров как ось кадров. Classifier-free guidance удваивает эту размерность, счётчик выходил в два раза больше числа тайлов, и проба говорила OK. Теперь она читает только 5-мерные тензоры, где ось кадров настоящая.
Урок теперь — правило проекта: никаких тихих откатов, и каждая проба получает контрольный режим, который намеренно ломает механизм и обязан вернуть FAIL. Проба, которая ни разу не падала, ничего не доказывает. Дооснащение каждой из одиннадцати проверочных техник проекта контрольным режимом всё ещё открыто. Как я пишу такие правила для агентов, описано в посте о моём CLAUDE.md.
Бонусная идея: меньше тайлов, а не умнее
Гипотеза без прогонов за ней. Detail Daemon (и его порт для ComfyUI) перестраивает расписание сигм так, чтобы поздние, низкошумные шаги добавляли детали, без переобучения.
Первая половина шагов шумоподавления занимается низкими частотами: распределением цвета, композицией, крупными формами. Это можно делать на уменьшенной версии за один проход, без тайлов и без швов на низких частотах. Вторая половина добавляет детали, и Detail Daemon делает это через расписание, а не через рекурсивное повторное шумоподавление. Если это подтвердится, половина шагов станет дешёвой и без швов, а тайлинг останется только в фазе деталей, вероятно всё равно нужный выше примерно 2048 по стороне, так как карты внимания на 4096×4096 тоже не помещаются в 80 ГБ. Эксперимент по экономии шагов (пять методов на пяти бюджетах шагов, детальность измеряется дисперсией Лапласиана, энергией высоких частот и наклоном спектра) написан, но не запущен. Узлы для тайлинга и частот, которые я реально использую в продакшен-графах, — в посте о пользовательских узлах ComfyUI и на /comfyui/.
Что всё это не доказывает
- Полная абляция не проведена. Прогон SANA, о котором я писала в апреле, — не полное обучение и не сравнение с базовыми линиями, и его журнала нет в репозитории. Seam PSNR, соотношение ΔE между границами тайлов и их внутренностями, HF-SSIM по маскам кожи и волос не измерены.
- Я не знаю, какая архитектура победит. Блочное линейное внимание на SANA должно выиграть по памяти, кэшированный Klein — по качеству, внимание в стиле SVD — самый прямой перенос. Какая победит в настоящей абляции, я гадать не буду.
- Я не знаю, как это масштабируется. Все пробы шли на сетках от 3×3 до 7×7; сетке из 100 тайлов нужно сжатие в стиле FramePack или скользящее окно.
- Семантический уровень не проверен, а идея Detail Daemon — эскиз.
Обновление, сентябрь 2026. Ничто из этого не изменилось. Последние коммиты эксперимента в проекте — от 26 апреля. В мае я исправила скрытый краш в пробе до того, как он мог стоить времени GPU, и подготовила проект к долгим прогонам: список функций, журнал проблем и шлюз синтаксиса, который должен пройти до аренды GPU. Проверяя эту правку, я нашла, что работа ещё не закоммичена и лежит на диске, а это нарушает моё собственное правило, что git — источник истины. Следующий шаг тот же, что и в апреле: одна сессия на GPU, которая перезапускает каждую зафиксированную гипотезу со своей пробой, а затем абляция. Вторая часть этой серии не опубликована, а кодовый репозиторий всё ещё приватный. Читайте всё выше как гипотезы с несколькими ранними сигналами.
Что я бы сделала иначе
- Негативные контроли с первого дня. Оба бага выше — именно такие, которые контрольный прогон ловит сразу.
- Смотреть на полосы до обучения на них. Скачки контента заметили после того, как первые два дообучения уже прошли.
- Одно изменение на сравнение. Первый прогон метода глобального превью против базовой линии отличался сразу по сэмплеру, силе, сиду, размеру изображения и негативному промпту, поэтому он ничего не говорил о самом превью. Исправление — выровнять все эти параметры и добавить прогон с выключенным превью.
Русский оригинал опубликован на Хабре.