Warum Diffusion auf 40-Megapixel-Fotos Nähte zeichnet und wie man Kacheln ein Gedächtnis gibt
Autorin: Anastasiia Butova, Ingenieurin für ComfyUI und Diffusionsmodelle, Belgrad · veröffentlicht 2026-04-26 · aktualisiert 2026-09-23
Übersetzung der englischen Fassung: English
Eine professionelle Retuschedatei hat 40 bis 150 Megapixel, und ein Diffusionsmodell verarbeitet jeweils ein bis vier davon, also zerschneidet jede Pipeline das Foto in Kacheln. Das bringt zwei Probleme: eine sichtbare Stufe an den Kachelrändern und ein Modell, das nicht weiß, was es gerade betrachtet. Dieser Beitrag behandelt, warum Überblenden die Stufe nicht entfernen kann, welche Gedächtnismechanismen aus der Videodiffusion sich von Frames auf Kacheln übertragen lassen, warum jede Kachel das ganze Bild und ihre eigenen Koordinaten bekommen sollte und was meine ersten Läufe zeigten, Fehlschläge eingeschlossen. Ich habe über zwanzig Jahre als Retuscheurin gearbeitet und bin im vierten Jahr damit, Diffusion auf Dateien wie diesen zum Funktionieren zu bringen; die Arbeit gehört zur Forschung an hochauflösendem img2img hinter Happyin.ai. Überarbeitet im September 2026: Korrekturen und spätere Ergebnisse tragen dieses Datum.
Warum alle kacheln
Retusche findet nicht bei 2048 Pixeln Kantenlänge statt. Eine Phase One IQ4 liefert 14200×10600, eine Hasselblad H6D-100c 11600×8700, eine Canon R5 8192×5464, und all das braucht noch Haut-, Haar-, Farb-, Licht- und Hintergrundarbeit. Aktuelle Modelle arbeiten nativ bei 1024 bis 2048: SDXL und SANA bei 1024 (SANA wurde weiter trainiert, bis 4K), FLUX und Klein akzeptabel bei 2048. Darunter sinkt die Qualität, und die Kachelanzahl steigt.
Bei Kachelgröße 1024 mit kleiner Überlappung sind es für eine 60-MP-Datei 75 bis 80 Kacheln, für 100 MP etwa 130, für 150 MP etwa 190. Die Überlappung verbirgt die Nähte und vervielfacht die Anzahl: dieselben 150 MP sind bei 25 % Überlappung etwa 270 Kacheln und bei 50 % etwa 540. 150 und mehr Kacheln pro Bild sind also ein normaler Arbeitsfall, und jeder Mechanismus, dessen Kosten mit dem Quadrat der Kachelanzahl wachsen, scheidet schon vor dem Start aus. Er passt nicht in 80 GB VRAM, und er passt auch nicht in 192 GB.
Warum Überblenden die Nähte nicht entfernen kann
Überlappung plus Überblendung ist die übliche Lösung, und Überblendung wirkt auf verschiedenen Frequenzen unterschiedlich. Bei glattem Inhalt (ein Himmelsverlauf, Hauttöne, ein weicher Abfall in einer Spiegelung auf Metall) verbirgt ein Crossfade einen Farbsprung gut. Bei Haaren, Stein, Körnung oder feinen Kratzern scheitert er auf eine von zwei Arten: Eine harte Stufe bleibt am Rand, oder die Textur wird verschmiert, weil man in der Überlappung zwei Texturen mittelt, die das Modell unabhängig voneinander gezeichnet hat.
Hinter dem Verschmieren steckt eine einfache Zahl. Zwei unkorrelierte Texturen gleichen Kontrasts, zu 50/50 gemittelt, behalten √0,5 ihres Kontrasts, etwa 71 %. In der synthetischen Abbildung unten habe ich in der Mitte der Überlappung 0,70 gemessen.
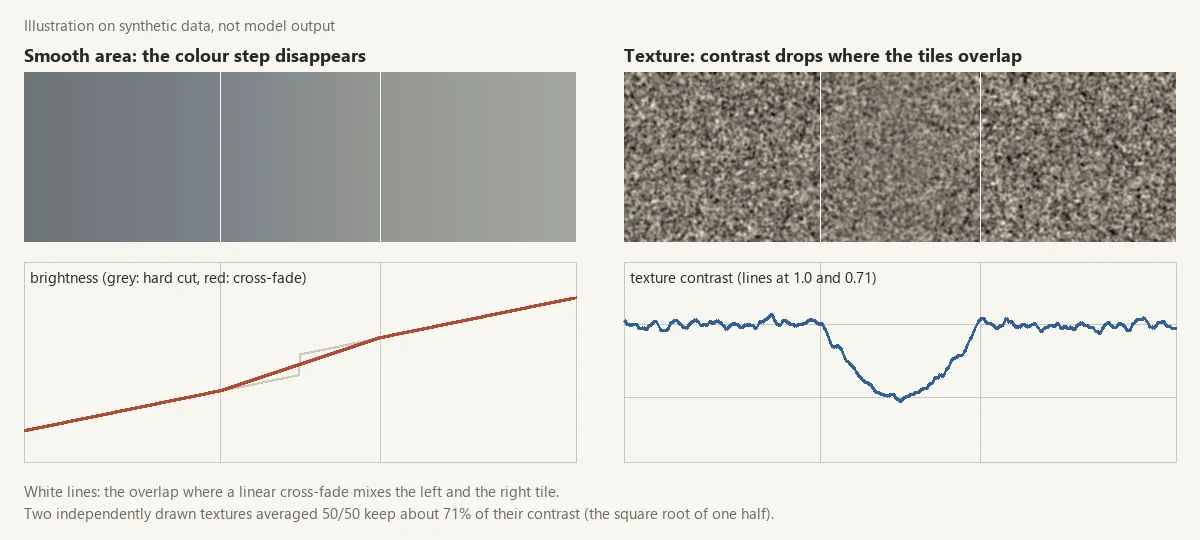
Ein einziger Regler kann beides nicht beheben: Je stärker man überblendet, desto weicher die Farbnaht, und desto flacher die Textur entlang jedes Kachelrands. Und die Farbstufe selbst entsteht, weil Kacheln unabhängig voneinander driften. Nichts sagt Kachel (3, 5), welche Farbe Kachel (3, 4) gewählt hat.
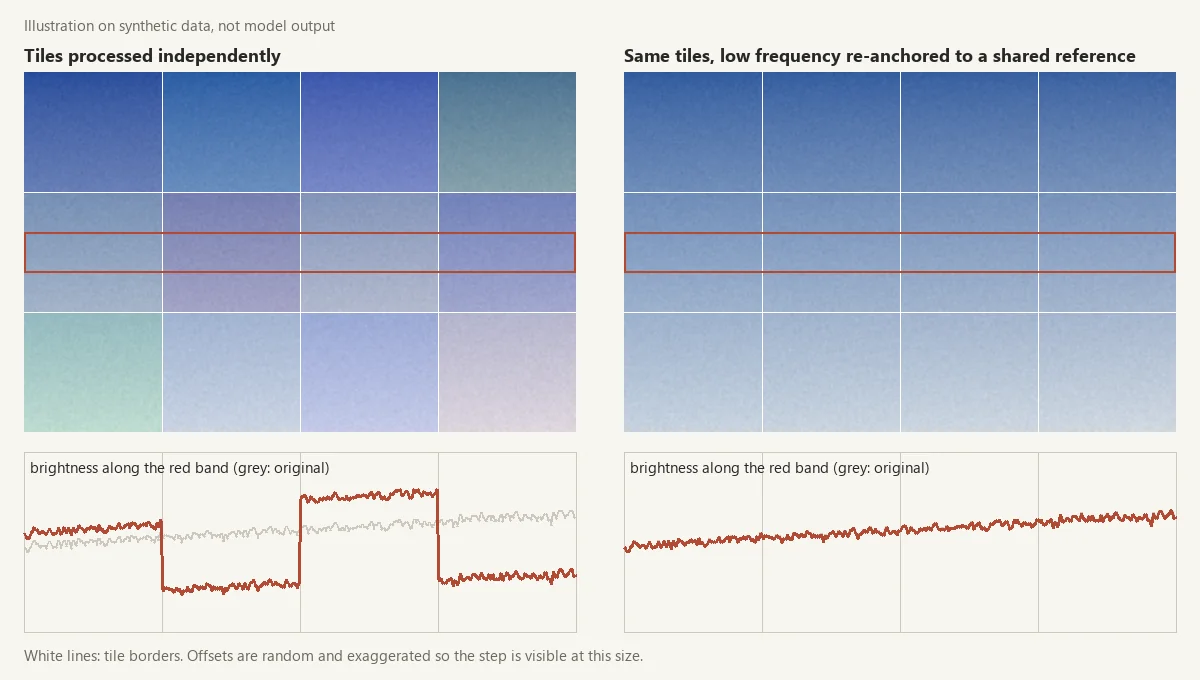
In diesem Spielzeugbeispiel fällt die größte Stufe an einem Kachelrand von 18,5 auf 0,5 von 255 Stufen. Die Versätze sind überzeichnet, aber das Prinzip ist die Richtung dieses ganzen Beitrags: Gib jeder Kachel eine Referenz, die sie mit ihren Nachbarn teilt, und richte die niedrigen Frequenzen an dieser Referenz aus, nicht aneinander. ResMaster macht etwas Ähnliches für die Generierung: Es richtet bei jedem Denoising-Schritt die niederfrequenten Komponenten jedes Patches an einem niedrig aufgelösten Referenzbild aus.
Was ein Gedächtnismechanismus für Kacheln leisten muss
- Kosten, die nicht quadratisch mit der Kachelanzahl wachsen. Volle 3D-Attention scheidet aus.
- Nutzung ohne Neutraining. Schon eine teilweise Nutzung nur bei der Inferenz ist ein großer Vorteil.
- Stetige, pixelgenaue Ausgabe. Wir retuschieren Textur und erzeugen keine Ästhetik. Modelle mit diskreten Tokens wie Cosmos, mit ihrem FSQ-Vokabular von 64K, quantisieren feine Details weg.
- Ein Grundbaustein, den ich herauslösen kann. Wan 2,1 (14B) und HunyuanVideo (13B) tragen lange Videos, Bewegungssteuerung, Audiosynchronisation und Mehrfach-Einstellungskomposition; die Hälfte davon löst Probleme, die ein Foto nicht hat, und ich würde all das mit VRAM bezahlen. SANA-Video, AnimateDiff, SVD und FramePack isolieren jeweils ihren Gedächtnis-Grundbaustein. Und wenn möglich Apache 2.0, damit das Ergebnis ohne Verhandlung in ein Produkt darf.
Die Hauptachse, nach der ich wähle, ist, wie ein Mechanismus fertige Kacheln vergisst, damit nicht 200 davon mit ihren ganzen K/V-Tensoren im VRAM liegen. Ein gleitendes Fenster behält die letzten wenigen und ist für alles Entfernte blind. Geometrische Kompression behält Nachbarn in voller Auflösung und entfernte Kacheln komprimiert, sodass die Gesamtmenge konvergiert. Akkumulierter Zustand behält überhaupt keine Kacheln, nur zwei kleine laufende Summen.
Idee eins: Videomodelle merken sich Frames, Fotomodelle nicht
Mit „Fotomodell“ meine ich ein gewöhnliches Bild-zu-Bild-Diffusionsmodell: SDXL, FLUX, Klein, SANA. Wenn ein Videomodell Frame 18 erzeugt, sieht es auch 17, 16, einige frühe Schlüsselframes, manchmal den ersten. Dieses Gedächtnis liegt in der Architektur (Attention über die Zeitachse, ein akkumulierter Zustand, ein KV-Cache zwischen Abschnitten), und deshalb flackern Hintergründe nicht und Farben driften nicht zwischen Frames.
Ein Fotomodell, das Kachel (3, 5) verarbeitet, bekommt ihre Pixel und einen Textprompt. Kein Nachbar links, keiner darüber, keine Ahnung, dass das ein einziges Bild ist. Verschiebt man das Gedächtnis von der Zeitachse auf das räumliche Raster, adressiert man die Nähte (Kacheln merken sich die Farbe ihrer Nachbarn) und einen Teil der Semantik (die Haarkachel weiß, dass unterhalb davon ein Hals beginnt und kein Fell). Die Videoliteratur kennt acht architektonische Gedächtnisklassen, und nicht alle überleben den Übergang auf eine Fläche:
| Typ | Mechanismus | Beispiele | Für Kacheln |
|---|---|---|---|
| A · volle 3D-Attention | jedes Token sieht jedes Token | Wan | streichen: quadratisch, startet nicht bei 64+ Kacheln |
| B · lineare Block-Attention | laufende Summen S = Σ φ(K)ᵀV, Z = Σ φ(K)ᵀ | SANA-Video | primär: konstanter Zustand |
| C · gleitendes Fenster | Attention auf die letzten W Frames | CausVid | Reserve: gut lokal, blind für entfernte Kacheln |
| D · faktorisierter Raum und Zeit | zeitliche Schichten nach jeder räumlichen Schicht | SVD, AnimateDiff | direkte Abbildung: „über alle Frames“ wird „über alle Kacheln“ |
| E · Ankerframe | jeder Frame sieht einen Anker | Rolling Forcing, StreamingT2V | Zusatz: eine Ankerkachel gleicht die Farbe ab |
| F · geometrische Kompression | nahe Frames voll, ferne komprimiert | FramePack | primär: Nachbarn voll, Diagonalen 2×, ferne 4× |
| G · Cache-Teilung | Merkmale einmal berechnet, über Schritte wiederverwendet | Ca2-VDM | Zusatz: Merkmale der Nachbarn einmal berechnen |
| H · diskrete Tokens | FSQ-Vokabular, Vorhersage des nächsten Tokens | Cosmos | streichen: unvereinbar mit stetiger Pixelbearbeitung |
Drei davon sind wichtig.
B, lineare Block-Attention aus SANA-Video. Jeder Block (dort ein Frame, hier eine Kachel) addiert seine Schlüssel und Werte zu zwei Akkumulatoren, und der nächste Block liest aus den Akkumulatoren statt aus jedem vorherigen Token. Der Zustand wächst nicht mit der Anzahl der Blöcke, also kosten hundert Kacheln so viel wie zehn. SANA nutzt lineare Attention ohnehin in jeder Schicht, der Grundbaustein ist also kostenlos vorhanden.
Update, September 2026. Die Aprilversion gab diesem Zustand für SANA 1,6B etwa 380 MB, mit einer Breite von 2.304 und 28 Schichten. Beide Zahlen waren für dieses Modell falsch: 2.304 ist die Breite der Text-Encoder-Embeddings (
caption_channels), und 28 Schichten gehören zum 0,6B-Modell. SANA 1,6B hat 20 Schichten mit je 70 Köpfen zu 32 Dimensionen (Konfiguration), und seine lineare Attention hält S und Z pro Kopf, in fp32 (SanaLinearAttnProcessor2_0in diffusers). Das sind 33×32 Zahlen pro Kopf, etwa 6 MB für alle 20 Schichten. Selbst eine grobe Zählung, eine 2.240×2.240-Matrix pro Schicht in fp16, ergibt etwa 200 MB. Die Schlussfolgerung wird stärker: Der Zustand ist konstant in der Anzahl der Kacheln und klein.
D, faktorisierter Raum und Zeit, wie bei SVD. SVD fügt nach jeder räumlichen Schicht eines SD-2,1-UNet zeitliche Faltungs- und Attention-Schichten ein: 656 M neue Parameter von 1.521 M, der Videoteil ist also 43 % des Modells. (Die russische Originalfassung sagte SDXL; das SVD-Paper nennt SD 2,1. Im September 2026 korrigiert.) Mechanisch ist es eine Umformung: Nach einem räumlichen Block wird (B·T, C, H, W) zu (B·H·W, T, C), durchläuft zeitliche Attention und kommt zurück. Setzt man die Anzahl der Kacheln an die Stelle von T, wird „wie sieht dieser Pixel in jedem Frame aus“ zu „wie sieht diese Position in jeder Kachel aus“. Es ist die wörtlichste Übertragung, und ich erwartete, dass sie die zerbrechlichste ist. AnimateDiff-Bewegungsmodule sind dieselbe Idee, schon trainiert und bei der Inferenz nutzbar, aber auf 32 Frames begrenzt, also 32 Kacheln.
F, geometrische Kompression aus FramePack (Lvmin Zhang, der Autor von ControlNet). Nahe Frames gehen mit voller Dichte in den Kontext, ferne stärker komprimiert, sodass die Gesamtmenge gegen eine feste Grenze konvergiert. Für Kacheln: (3, 5) sieht (2, 5), (3, 4), (3, 6) und (4, 5) mit voller Dichte, Diagonalen mit 2-facher Kompression, ferne Kacheln mit 4-facher. Der Kontext bleibt gleich, egal wie groß das Foto ist, sodass 16×16-Raster ohne quadratische Explosion funktionieren.
Die nächsten bestehenden Arbeiten gehen in Nachbarrichtungen. PatchVSR passt ein Videomodell für patchweise Superresolution an, aber seine zeitliche Attention bleibt innerhalb eines Patches, über dessen Frames. Sliding Tile Attention beschleunigt die Attention in Video-DiTs um das 2,8- bis 17-Fache gegenüber FlashAttention-2; die Idee der gleitenden Kacheln stammt von dort, aber es ist ein Geschwindigkeitsergebnis. (Im Aprilteil stand für diese Spanne „end-to-end“; im Paper gilt sie für die Attention. Im September 2026 korrigiert.) FrescoDiffusion (März 2026) ist der nächste Verwandte: gekachelte Entrauschung für 4K-Bild-zu-Video, jede Kachel bei jedem Zeitschritt mit einer niedrig aufgelösten Referenz verschmolzen. Es erzeugt Video, statt ein Foto zu bearbeiten. Ich habe kein systematisches Experiment gefunden, das die zeitliche Attention eines Videomodells als Attention zwischen Kacheln für ein Standbild über mehrere Backbones prüft.
Ein Datensatz aus Nachbarn, nicht aus Kacheln
Fast niemand schreibt über den Datensatz, und er ist die halbe Aufgabe. Um zu lernen, sich Nachbarn zu merken, muss das Modell Folgen von Nachbarn sehen. Ich verwende Streifen: eine gerade Zeile oder Spalte durch ein Foto, in Kacheln geschnitten.
Die Quelle ist ein Schmuck-Datensatz, den ich zur Hand hatte, rund 52.500 Fotos. Schmuck bündelt alles, woran naives Kacheln scheitert: dünne Kanten, Brechung, reflektierendes Metall mit ungleichmäßigen Schatten, Steine mit feiner Textur. Jedes Foto wird in drei Maßstäben (512, 768, 1024), mit drei Überlappungen (0 %, 25 %, 50 %) und in vier Richtungen zerschnitten. Gespeichert werden nur Streifen von links nach rechts und von oben nach unten; die umgekehrten entstehen über np.flip im Loader. Die Umkehrung ist wichtig für die lineare Block-Attention, denn sie ist kausal: Eine Kachel sieht nur die laufende Zusammenfassung der Kacheln davor, und wenn sie nur von links nach rechts trainiert wurde, hat sie keinen anderen Weg je gesehen.
Auf dem Papier sind das etwa 70 Streifen pro Foto und 3 bis 4 Millionen Beispiele für den ganzen Satz. Die Pipeline ist so entworfen, dass sie bei 400.000 gespeicherten Streifen anhält, mit Kacheln auf 256×256 verkleinert für die erste Runde und den Originalen für einen späteren Zuschnitt. Im September 2026 nachgeprüft: Laut seinem Manifest hat der bisher einzige Lauf 7.368 Streifen aus 100 Fotos geschnitten, 74 pro Foto, nahe an der Schätzung.
Beim Aufbau entstand die nützlichste Beobachtung der Woche: Streifen überqueren Objektgrenzen. Bei einem Foto von 5184×3456 geht Zeile 4 im Maßstab 512 über Haut, Haut, Haut, Fingerspitze, Armbandperlen. Bei 24 bis 60 Bildern pro Sekunde liegen aufeinanderfolgende Videoframes 17 bis 42 ms auseinander, mit kleiner Bewegung und sanftem optischem Fluss; benachbarte Kacheln springen dagegen in einem Schritt von Haut zu Metall. Ein Schritt von einer halben Kachel lässt einen Streifen wie einen langsamen Schwenk wirken, und der endgültige Satz mischt alle drei Überlappungen, von harten Sprüngen bis zu sanften Schwenks.
Was ich im April laufen ließ
Zum Zeitpunkt des ursprünglichen Beitrags nur SANA. Es wurde bei 512, dann 1024, 2K und 4K trainiert, also ist eine 1024-Kachel nativ, und die lineare Attention ist schon im Backbone. Ich habe ein kleines Training auf Teststreifen bei Kachelgröße 1024 gemacht, mit zwei Fragen: Konvergiert der Verlust, und überträgt sich der Mechanismus überhaupt von der Zeitachse auf die räumliche Fläche? Der Verlust konvergierte, und das Modell lernte, benachbarte Kacheln so abzugleichen, wie es früher benachbarte Frames abgeglichen hatte. Ich habe keine Zahlen aus einem Testlauf veröffentlicht, und ich tue es auch jetzt nicht.
Update, September 2026. Beim erneuten Durchsehen des Projekt-Repositorys fand ich kein Protokoll dieses SANA-Trainings darin; die Verlustkurven, die es führt, gehören zu zwei anderen Portierungen. Behandle den SANA-Satz oben also als meinen Aprilbericht, nicht als Beleg. Was die Laufnotizen dieser Woche enthalten: Bei der Inferenz veränderte das Einschalten des akkumulierten SANA-Zustands die Ausgabe um durchschnittlich 19,5 Stufen von 255, wo die Plausibilitätsprüfung unter 0,5 anhält. Der Mechanismus ist also kein stiller Nullpfad, und das ist viel weniger als „besser“. Die beiden anderen Portierungen wurden auf Kachelsequenzen aus einem separaten Satz von etwa 7.000 Fotos mit 1024 px und mehr feinabgestimmt. SDXL mit SVD-artiger Attention über Kacheln: Der gleitende Mittelwert des Verlusts über 100 Schritte fiel um etwa 40 %, und die Vorhersagen hatten erkennbare Struktur, aber ein diagonales Moiré, das am Kachelraster ausgerichtet war, das ich meiner Implementierung zuschreibe, die Schlüssel und Werte über Kacheln mittelt. AnimateDiff-Bewegungsmodule auf SD 1,5: Die Gewichte änderten sich (Frobenius-Norm des Updates 15,28), trotzdem sahen die Ausgaben vor und nach dem Feintuning fast identisch aus. Die Notizen widersprechen sich, wie weit der Verlust gefallen ist, deshalb lasse ich die Zahl weg. Ich lese die identischen Ausgaben als negatives Ergebnis für Bewegungsmodule auf Kacheln, und meine Arbeitserklärung ist der Inhaltssprung oben: Die Module tragen eine Annahme glatter Bewegung, die Fotos nicht erfüllen. Beide waren untertrainierte Schnappschüsse, die Zahlen sind also eine untere Grenze, kein Ergebnis.
Idee zwei: jede Kachel bekommt das ganze Bild und ihre Position
Wenn du ein Foto von 6000×4000 in Kacheln schneidest, hältst du das ganze Bild in der Hand, und es nicht zu nutzen wäre seltsam. Verkleinere es im Latent-Raum und gib es zusammen mit jeder Kachel als zusätzliche Kanäle in die erste Faltung. Füge die Position der Kachel als zwei weitere Kanäle hinzu, (x, y) ∈ [−1, 1], damit Kachel (3, 5) weiß, dass sie (3, 5) ist und nicht irgendwelche 512 Pixel im Nichts. PatchVSR macht beides für Video-Superresolution: Ein globaler Zweig sieht das verkleinerte ganze Video, und die Patch-Position wird ins Modell eingespeist.
Was Position wert ist: PaDIS
PaDIS (Hu et al., NeurIPS 2024) trainiert einen Diffusions-Prior nur auf Patches und hängt an jeden Patch zwei Positionsarrays an: die x- und y-Koordinaten jedes Pixels im vollen Bild, auf [−1, 1] skaliert, ohne Rauschen darauf. Die Ablation in ihrem Anhang (Tabelle 6, CT-Rekonstruktion) ist deutlich: 33,57 dB PSNR mit Position, 23,25 dB ohne, 24,51 dB ohne Position selbst bei Initialisierung aus einer Basisrekonstruktion. Die Autoren schreiben, das Netz habe den patchbasierten Prior „überhaupt nicht gelernt“. Zehn Dezibel sind der Abstand zwischen funktionierend und nicht funktionierend.
Zwei Vorbehalte, bevor man diese Zahl übernimmt. Es geht um CT, nicht um Fotos, und um ein Pixelraum-Modell, das von Grund auf auf Patches trainiert wurde. Niemand hat gemessen, was Koordinaten einem vortrainierten Latent-Modell bei 40-MP-Retusche bringen; dieses Experiment steht bei mir ganz oben auf der Liste und ist nicht erledigt.
Warum es wichtig ist, sieht man leicht. Ohne Position muss eine Funktion jeden Patch ohne Möglichkeit wiederherstellen, Wissen an einen Ort zu binden („Gesichter meist hier, Himmelsverlauf dort“), also mittelt sie, und der Mittelwert sieht wie Rauschen aus. Zwei Zahlen pro Pixel kosten fast nichts, und fast keine gekachelte Pipeline speist sie ein, vermutlich weil ein vortrainiertes Modell eine feste Eingangsbreite hat und jeder zusätzliche Kanal Training bedeutet.
Drei Ebenen dessen, was eine Kachel wissen sollte
| Ebene | Bedeutung | Wer macht es |
|---|---|---|
| geometrisch | „Ich bin Kachel (3, 5) eines 8×8-Rasters“ | Koordinatenkanäle von PaDIS |
| visuell | „Das ganze Bild sieht so aus“ | DemoFusion, FreeScale, DC-VSR, ResMaster |
| semantisch | „Das ist Haut, daneben Haar, erfinde kein Ohr“ | AccDiffusion v2, eine VLM-Beschreibung pro Kachel |
Gekachelte VAE liefert von Haus aus die Ebene null: Pixel und einen globalen Prompt.
Für die visuelle Ebene funktionieren zwei Dinge: ein verkleinertes VAE-Latent des ganzen Bildes in der ersten Faltung (erhält räumliche Struktur, Farbe, Licht) oder ein Vektor mit 64 Dimensionen aus globalen Statistiken (mittlere Farbe, Belichtung, Weißabgleich), der AdaLN-Zero in jedem Block moduliert, was billiger ist, aber keine räumliche Information trägt. Eine CLIP-Bildeinbettung über IP-Adapter funktioniert nicht gut: Ein Vektor ohne räumliche Achsen kann nicht sagen „die obere Kante dieser Kachel ist dunkelblauer Himmel, die untere blass“.
Ich habe das gemessen statt angenommen. Eine kontrafaktische Prüfung an SDXL, mit echter Vorschau gegen eine Vorschau aus Zufallsrauschen bei Adapterstärke 0,4, ergab eine mittlere Differenz von 0,0066 pro Pixel (maximal 0,26), unter der Schwelle von 0,02, unter der ich ein Signal als dekorativ bezeichne. Der Bildencoder feuert bei jedem Aufruf, der Adapter läuft also und verändert fast nichts. Meine Vermutung im April war eine Encoder-Unstimmigkeit: Der Adapter war auf bigG-ViT-Bildeinbettungen trainiert, das Setup nutzte aber das übliche SDXL-Paar aus CLIP-L und CLIP-G.
Update, September 2026. Diese Vermutung ist noch ungeprüft. Das Protokoll der Prüfung zeigt einen zweiten Kandidaten: Das ganze Bild erreicht den Adapter als 224×224-Pixel, und das allein begrenzt schon, was er tragen kann.
Für die semantische Ebene ist der direkte Weg eine Beschreibung pro Kachel von einem VLM wie Florence-2, etwa 50 ms pro Kachel: Eine Kachel mit Schulter und Haar bekommt „Haut und Haar, kein Fell“, und eine halluzinierte Fellstruktur widerspräche dem eigenen Prompt. Die billigere Variante, die ich ausprobieren möchte, ist eine Beschreibung für das ganze Bild, bei der in jeder Kachel das Gewicht fehlender Token gesenkt wird, sodass die Himmelskachel Gesicht, Haar und Metall stummschaltet. AccDiffusion v2 baut Prompts auf Patch-Ebene in ähnlichem Geist aus einem Bildprompt. Auf meiner Seite ungetestet.
Zusammengenommen besteht die Eingabe einer Kachel aus ihrem eigenen Latent, zwei Koordinatenkanälen, dem verkleinerten Latent des ganzen Bildes und einer optionalen Segmentierungsmaske. Die Gewichte der neuen Eingänge müssen mit null beginnen. Sonst sieht das Modell bei Schritt null seinen normalen Eingang plus zufällige Gewichte, und das vortrainierte Verhalten bricht beim ersten Vorwärtsdurchlauf. Mit Null-Initialisierung startet es identisch mit dem Backbone und lernt, die neuen Kanäle allmählich zu nutzen, derselbe Trick wie die Null-Faltungen in ControlNet.
# Illustration, not production code: widen a pretrained first convolution
# so each tile can also receive its coordinates and a global preview.
import torch
import torch.nn as nn

def widen_first_conv(conv: nn.Conv2d, extra: int) -> nn.Conv2d:
    new = nn.Conv2d(conv.in_channels + extra, conv.out_channels,
                    conv.kernel_size, conv.stride, conv.padding)
    with torch.no_grad():
        new.weight.zero_()                     # new channels start silent
        new.weight[:, :conv.in_channels] = conv.weight
        new.bias.copy_(conv.bias)
    return new

def coord_channels(box, full_w, full_h, h, w):
    x0, y0, x1, y1 = box                       # tile position in the full image, px
    xs = torch.linspace(x0, x1, w) / full_w * 2 - 1
    ys = torch.linspace(y0, y1, h) / full_h * 2 - 1
    gy, gx = torch.meshgrid(ys, xs, indexing="ij")
    return torch.stack([gx, gy])               # (2, h, w), values in [-1, 1]
Fehler, die wie Ergebnisse aussahen
Nachträglich im September 2026 aus dem Projektprotokoll jener Woche ergänzt. Zwei Fehler und ein Beinahe-Fehler haben mich mehr gelehrt als die Läufe.
- Koordinaten, die nichts taten. Die Funktion, die Koordinatenkanäle hinzufügen sollte, gab das Bild unverändert zurück und wurde nie aufgerufen, obwohl ihr Docstring Verkettung in die erste Faltung versprach. Eine ausdrückliche Ablation zeigte einen Unterschied von genau 0,0. Die Korrektur für den trainingsfreien Pfad, eine positionsabhängige Farbtönung, war dann zu schwach: ±1 % sind etwa 2,5 Stufen von 255, unter dem JPEG-Rauschen. Sie ging auf 5 %, etwa 13 Stufen.
- Beinahe-Fehler: ein Adapter, durch das Attention-Backend abgeschaltet. Ein Code-Review der kombinierten Pipeline fand xformers, das nach
load_ip_adapter()aktiviert wurde. Fällt xformers zurück, ersetzt das die Attention-Prozessoren von IP-Adapter durch gewöhnliche, ohne Fehlermeldung, und der Adapter hat dann einfach keine Wirkung mehr. Der Prüfer bewertete das als wahrscheinlich (85 %); kein Lauf zeigte, dass es passiert war. Die Reihenfolge ist jetzt VAE-Kachelung, xformers, dann der Adapter, mit einer Prüfung der Prozessorklasse danach. - Eine Prüfung, die zufällig bestand. Die erste AnimateDiff-Prüfung las die führende Dimension von 4-D-Tensoren als Frame-Achse. Classifier-Free Guidance verdoppelt diese Dimension, die Zählung kam als das Doppelte der Kachelanzahl heraus, und die Prüfung meldete OK. Sie liest jetzt nur noch 5-D-Tensoren, bei denen die Frame-Achse echt ist.
Die Lehre ist jetzt eine Projektregel: keine stillen Rückfälle, und jede Prüfung bekommt einen Kontrollmodus, der den Mechanismus absichtlich bricht und ein FAIL liefern muss. Eine Prüfung, die nie fehlgeschlagen ist, beweist nichts. Die Nachrüstung eines Kontrollmodus für jede der elf Verifikationstechniken im Projekt ist noch offen. Wie ich solche Regeln für Agenten schreibe, steht im Beitrag über meine CLAUDE.md.
Bonusidee: weniger Kacheln statt klügerer
Eine Hypothese ohne Läufe dahinter. Detail Daemon (und sein ComfyUI-Port) formt den Sigma-Zeitplan so um, dass die späten, rauscharmen Schritte mehr Details hinzufügen, ohne Neutraining.
Die erste Hälfte der Entrauschungsschritte übernimmt niedrige Frequenzen: Farbverteilung, Komposition, große Formen. Das könnte in einem Durchlauf auf einer verkleinerten Version laufen, ohne Kacheln und ohne niederfrequente Nähte. Die zweite Hälfte fügt Details hinzu, und Detail Daemon macht das über den Zeitplan statt über eine rekursive Neuentrauschung. Wenn das stimmt, ist die Hälfte der Schritte billig und nahtlos, und Kachelung überlebt nur in der Detailphase, vermutlich weiterhin nötig oberhalb von etwa 2048 Kantenlänge, da Attention-Karten bei 4096×4096 auch nicht in 80 GB passen. Das Experiment zur Schrittersparnis (fünf Methoden bei fünf Schrittbudgets, Detail gemessen über Laplace-Varianz, Hochfrequenzenergie und spektrale Steigung) ist geschrieben, aber nicht gelaufen. Die Kachel- und Frequenz-Nodes, die ich in Produktionsgraphen tatsächlich nutze, stehen im Beitrag über eigene ComfyUI-Nodes und auf /comfyui/.
Was nichts davon beweist
- Die volle Ablation ist nicht gemacht. Der SANA-Lauf, den ich im April berichtet habe, ist weder ein vollständiges Training noch ein Vergleich gegen Baselines, und sein Protokoll liegt nicht im Repository. Die Naht-PSNR, das ΔE-Verhältnis zwischen Kachelrändern und Inneren sowie HF-SSIM auf Haut- und Haarmasken sind nicht gemessen.
- Ich weiß nicht, welche Architektur gewinnt. Lineare Block-Attention auf SANA sollte beim Speicher gewinnen, ein gecachtes Klein bei der Qualität, die SVD-artige Attention ist die direkteste Übertragung. Welche in einer echten Ablation gewinnt, rate ich nicht.
- Ich weiß nicht, wie es skaliert. Jede Prüfung lief auf 3×3- bis 7×7-Rastern; ein Raster mit 100 Kacheln braucht FramePack-artige Kompression oder ein gleitendes Fenster.
- Die semantische Ebene ist ungetestet, und die Detail-Daemon-Idee ist eine Skizze.
Update, September 2026. Daran hat sich nichts geändert. Die letzten Experiment-Commits im Projekt stammen vom 26. April. Im Mai habe ich einen latenten Absturz in einer Prüfung behoben, bevor er GPU-Zeit kosten konnte, und das Projekt für lange Läufe eingerichtet: eine Funktionsliste, ein Problemprotokoll und ein Syntax-Gate, das bestanden sein muss, bevor eine GPU gemietet wird. Beim Nachsehen fand ich diese Arbeit noch unkommittet auf der Festplatte, was meine eigene Regel bricht, dass Git die Quelle der Wahrheit ist. Der nächste Schritt ist derselbe wie im April: eine GPU-Sitzung, die jede behobene Hypothese mit ihrer Prüfung erneut laufen lässt, danach die Ablation. Der zweite Teil dieser Serie ist nicht veröffentlicht, und das Code-Repository ist weiterhin privat. Lies alles oben als Hypothesen mit ein paar frühen Hinweisen.
Was ich anders machen würde
- Negativkontrollen vom ersten Tag an. Beide Fehler oben sind die Sorte, die ein Kontrolllauf sofort fängt.
- Die Streifen ansehen, bevor man auf ihnen trainiert. Die Inhaltssprünge wurden erst bemerkt, nachdem die ersten zwei Feinabstimmungen schon gelaufen waren.
- Eine Änderung pro Vergleich. Der erste Lauf der globalen Vorschau-Methode gegen die Baseline unterschied sich gleichzeitig in Sampler, Stärke, Seed, Bildgröße und Negativ-Prompt, sagte also nichts über die Vorschau aus. Die Lösung war, alle anzugleichen und einen Lauf mit abgeschalteter Vorschau hinzuzufügen.
Das russische Original erschien auf Habr.